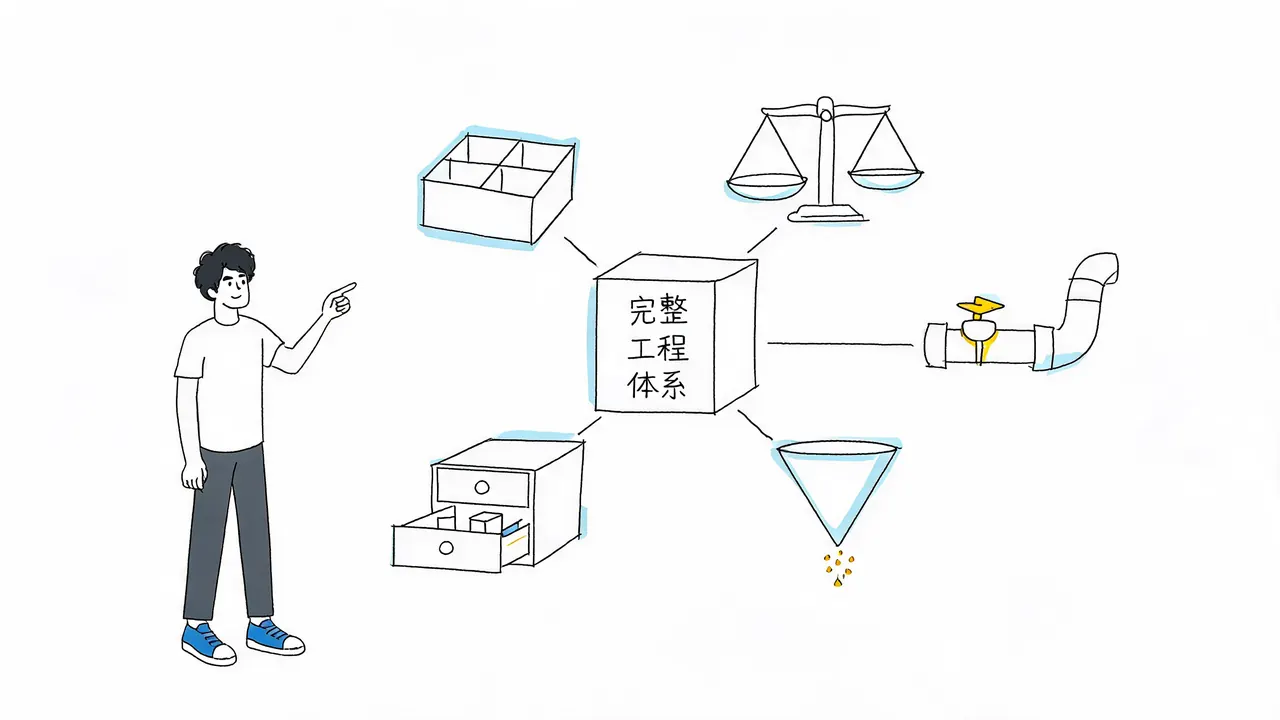
Agent 开发实战:超时重试的正确姿势与幂等性设计
在 AI Agent 工具调用中,简单的重试循环可能导致重复扣款等严重事故。本文深入解析超时重试的工程链路,涵盖错误分类、幂等校验、状态回查、局部补偿及熔断机制,帮助开发者构建安全可控的智能体执行系统。
共 20 篇文章
在 AI Agent 工具调用中,简单的重试循环可能导致重复扣款等严重事故。本文深入解析超时重试的工程链路,涵盖错误分类、幂等校验、状态回查、局部补偿及熔断机制,帮助开发者构建安全可控的智能体执行系统。
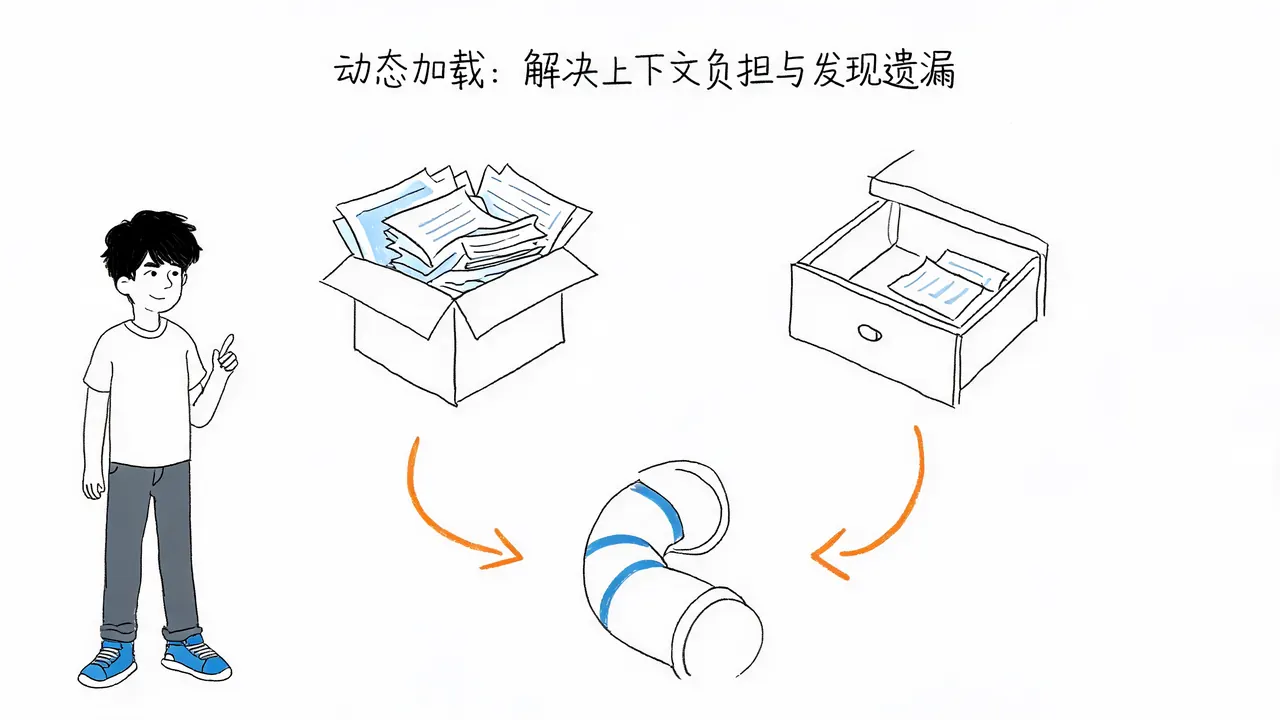
在开发 AI 智能体时,大模型经常选错工具或填错参数,往往是因为 Tool Schema 没写好。本文解析工具动态加载的两层架构,区分发现、选择与调用三类问题,并提供安全与性能优化建议。
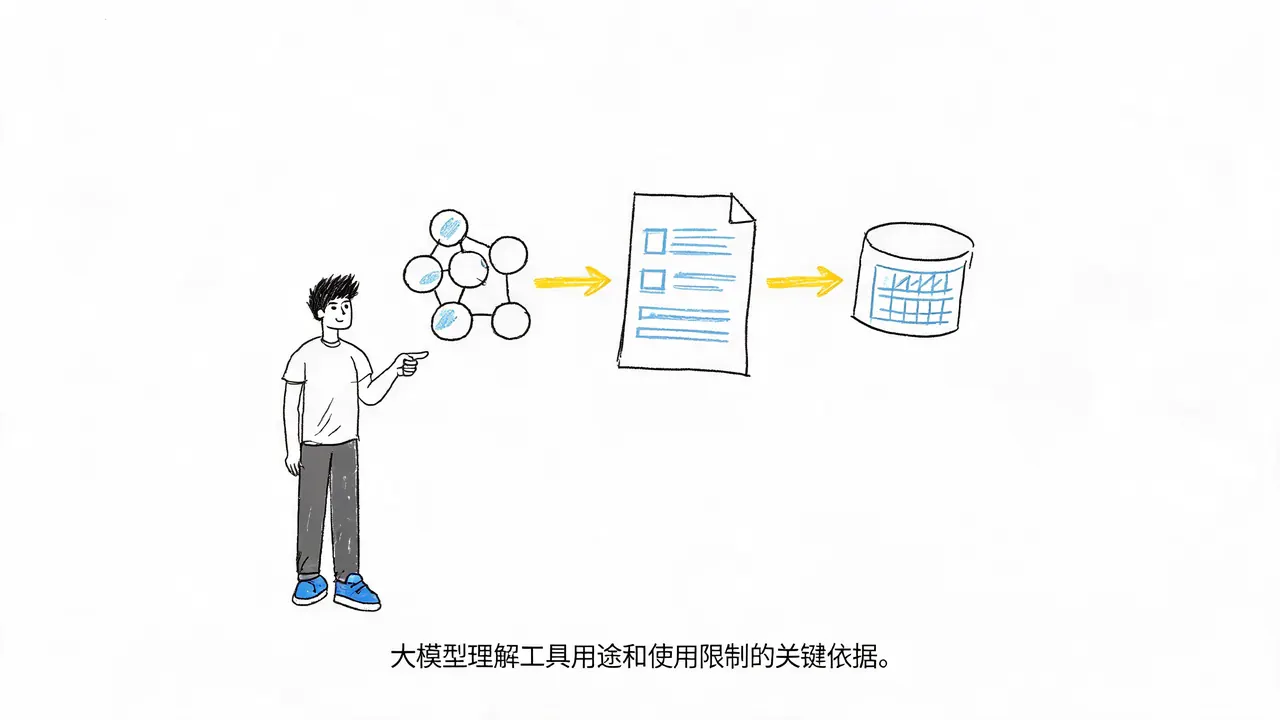
在开发AI智能体时,大模型经常选错工具或填错参数,往往是因为Tool Schema没写好。本文详解如何通过优化工具命名、参数描述及返回结构,提升模型对工具语义的理解,确保智能体稳定调用正确工具。
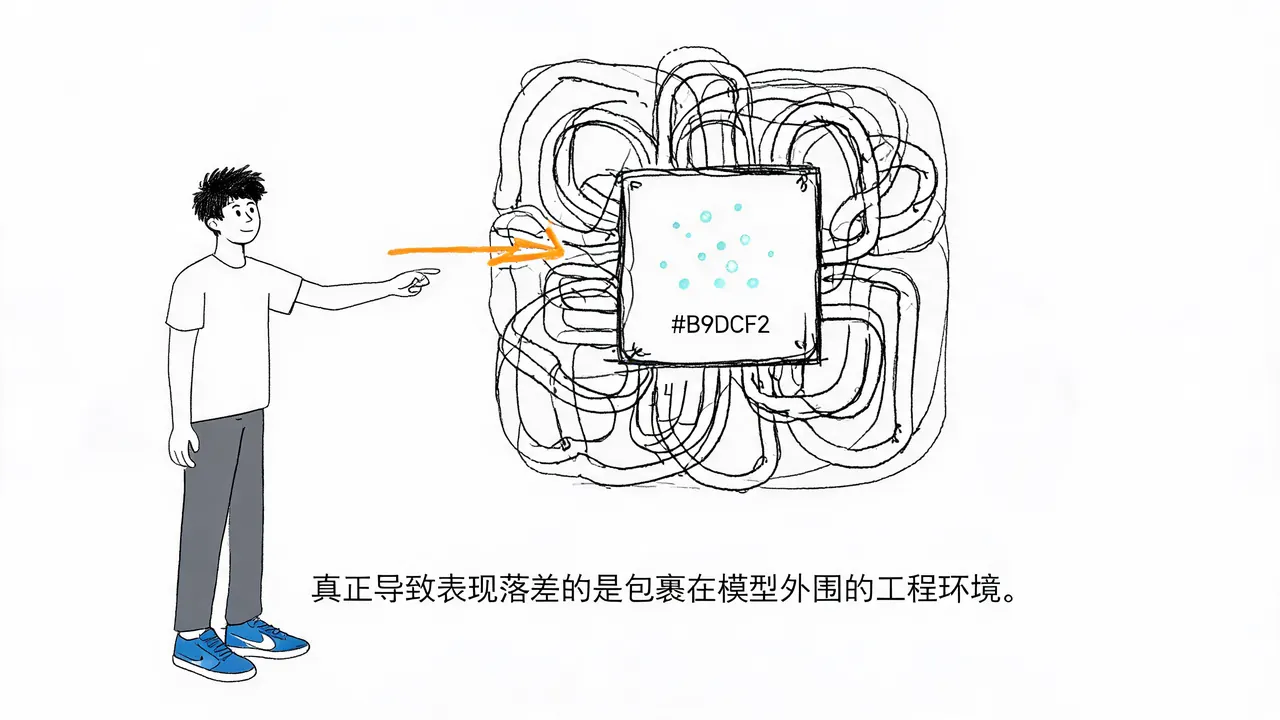
为什么 AI 模型在测试环境表现优异,上线后却频繁出错?本文深入解析 Harness Engineering(工程外壳)的概念,揭示上下文装配、工具管理及错误处理对 Agent 表现的关键影响,并提供基于运行链路的系统性排查策略。
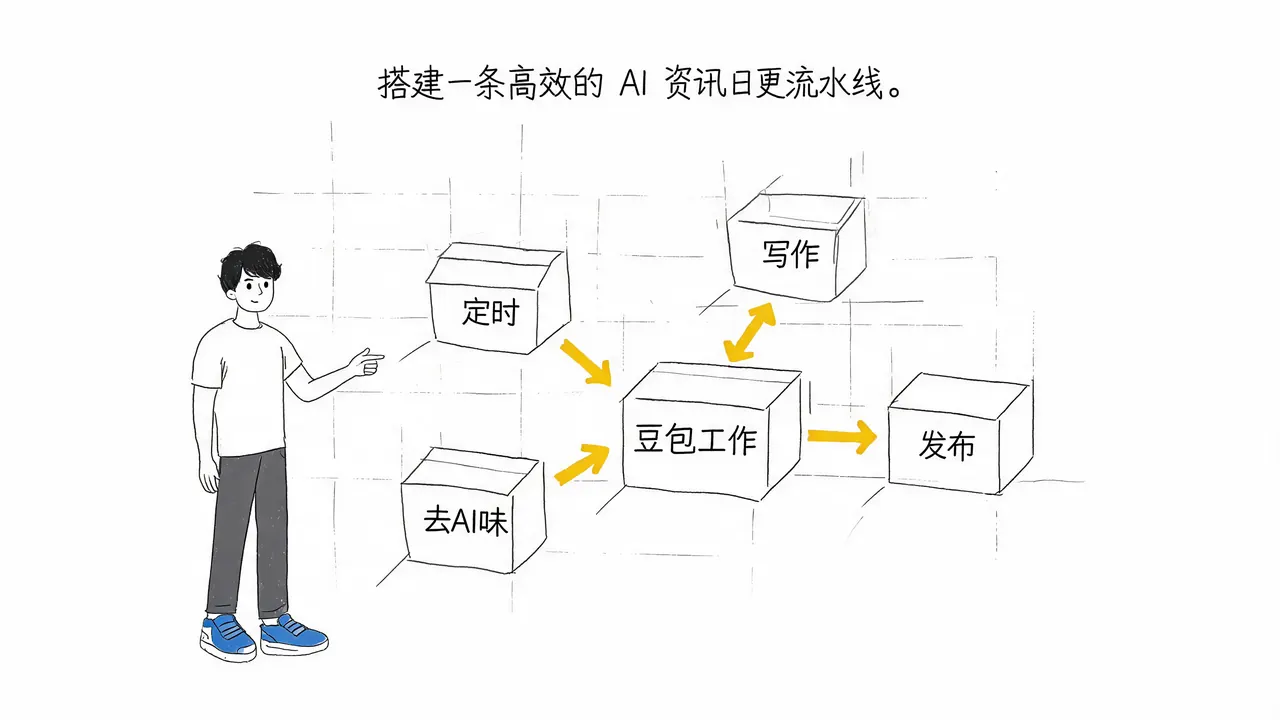
本文介绍如何利用豆包工作(Doubao Work)的 Agent 能力,结合定时任务、新媒体写作及去 AI 味技能,搭建一条全自动的 AI 资讯日更流水线。通过飞书原生打通实现数据闭环,实现从资讯抓取、选题撰写到成品输出的零人工干预,探索 AI 办公从工具时代向 Agent 时代的转变。
字节跳动推出的 TRAE SOLO 新版本正式内测,通过 Code 与 MTC 双模式设计,支持多任务并行与跨职能协作,旨在打通从想法到上线的全流程,重新定义 AI 智能体在工作中的应用。

深入解析 GitHub 爆火开源项目 Hermes Agent。对比其与 OpenClaw 在架构、技能学习、记忆体系及安全机制上的四大核心差异,探讨 AI Agent 从“工具集合”向“自我进化伙伴”转变的技术趋势。
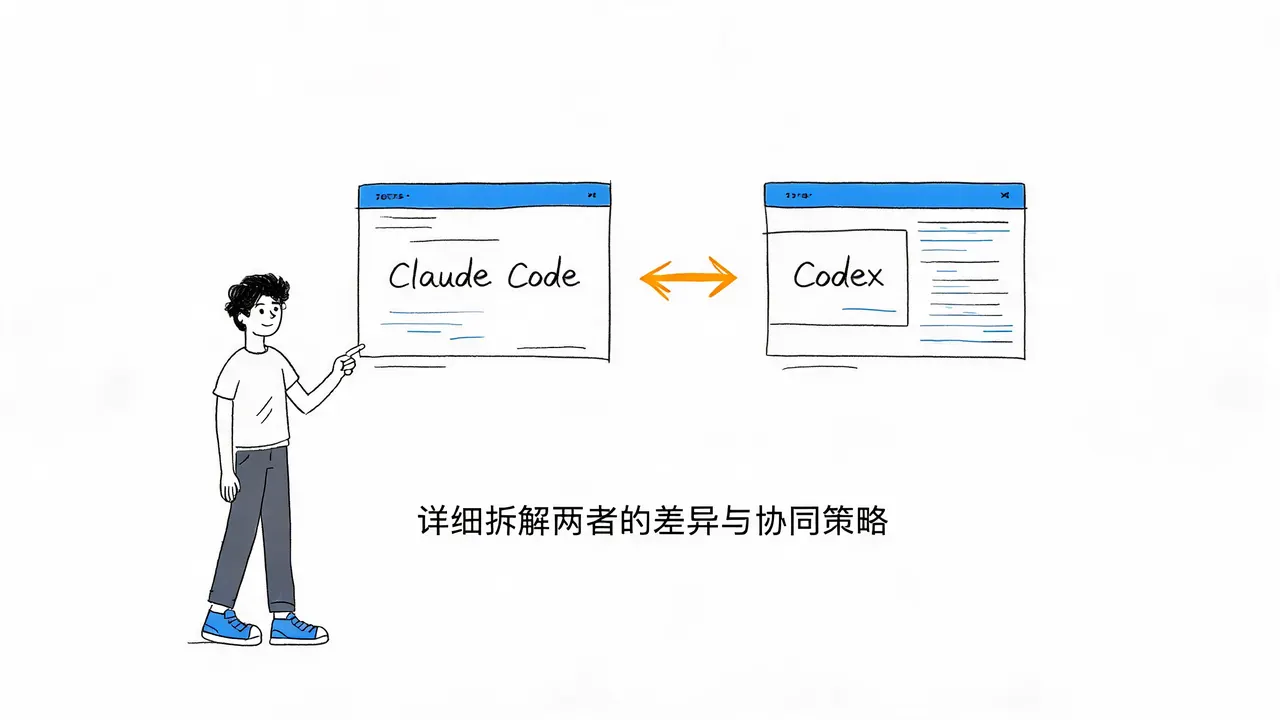
深入解析 Anthropic Claude Code 与 OpenAI Codex 的核心区别。从模型能力、上下文窗口、上手难度到价格策略,全面对比两款顶级 AI 编程 Agent,并分享“深度分析+执行验证”的高效协同工作流。