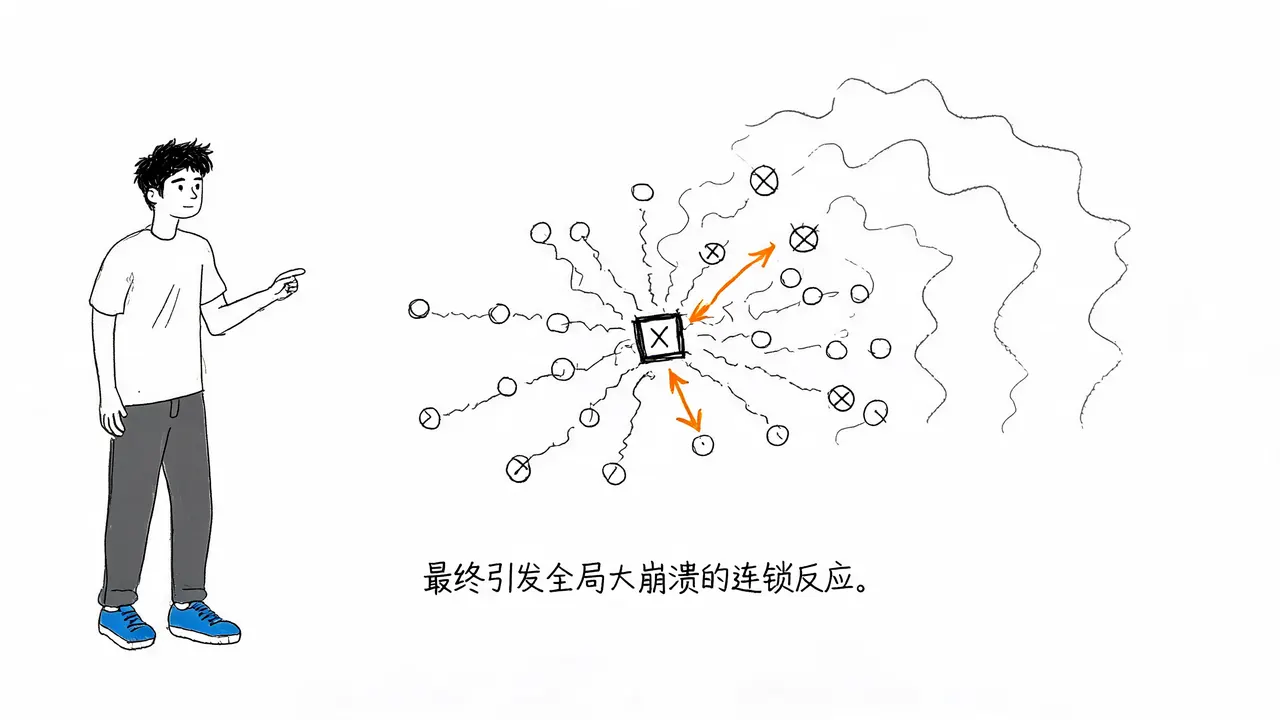
什么是雪崩效应?一个小服务怎么拖垮整个系统?
解析雪崩效应如何由局部小故障引发全局崩溃。探讨资源耗尽、重试风暴与级联故障的机制,以及熔断与降级策略在保护系统稳定性中的关键作用。
共 8 篇文章
解析雪崩效应如何由局部小故障引发全局崩溃。探讨资源耗尽、重试风暴与级联故障的机制,以及熔断与降级策略在保护系统稳定性中的关键作用。
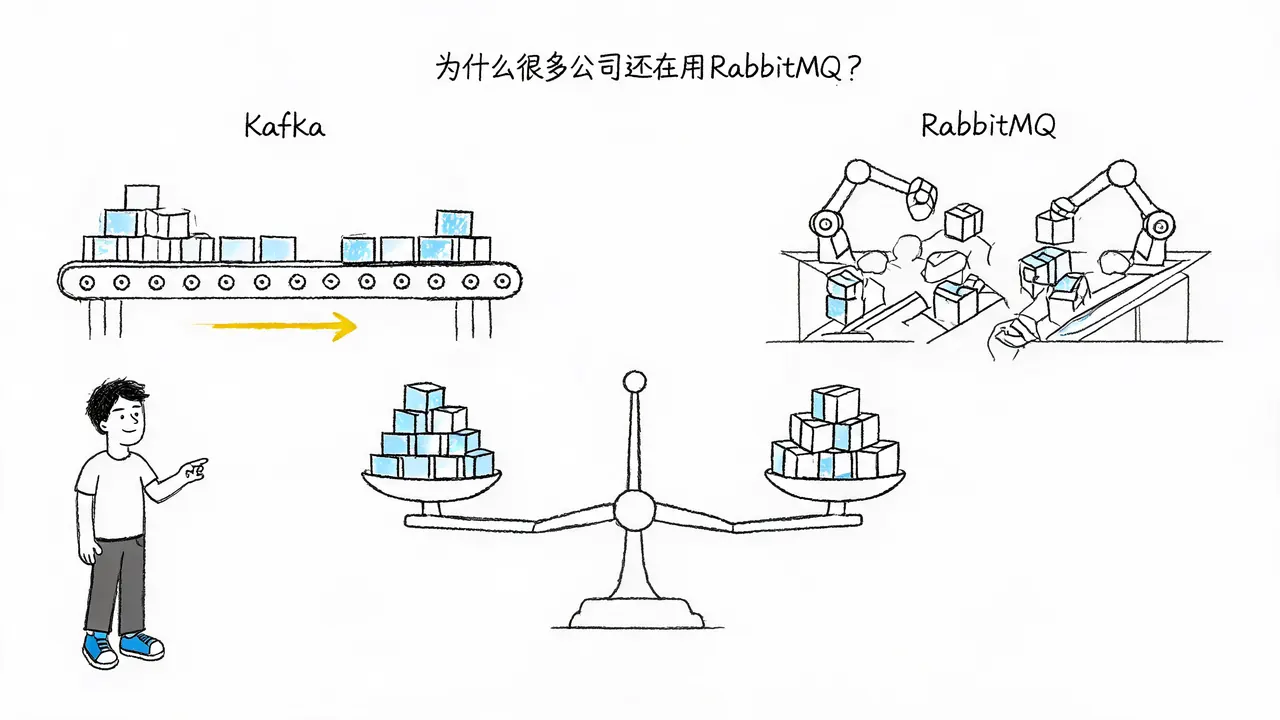
深入解析 Kafka 与 RabbitMQ 的底层设计差异。Kafka 是分布式事件流平台,侧重高吞吐与数据持久化;RabbitMQ 是传统消息代理,擅长灵活路由与低延迟。本文通过对比两者在消息模型、消费机制及适用场景上的不同,帮助开发者在系统架构中做出准确的技术选型。
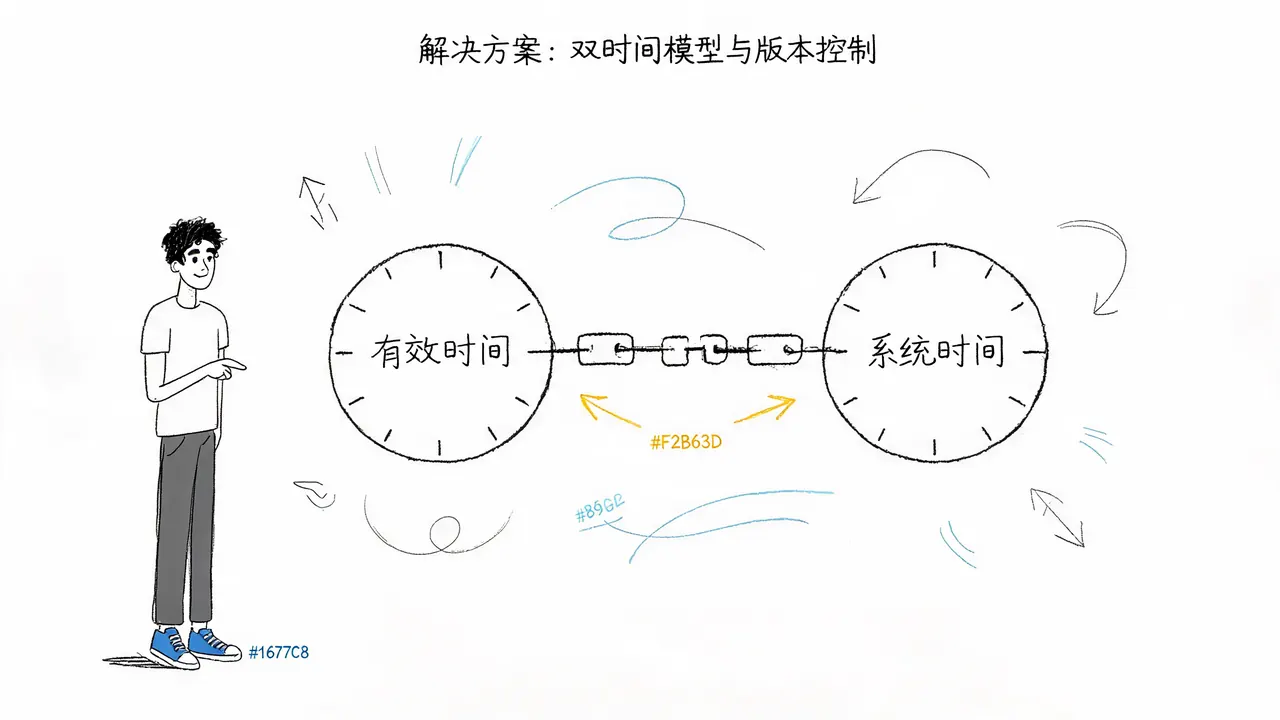
本文通过补录数据的场景,解析双时间机制中“业务生效时间”与“系统记录时间”的核心差异。探讨如何在 Agent 记忆及数据库设计中区分这两类时间,解决历史数据追溯难题,并分析引入双时间模型的代价与适用场景。
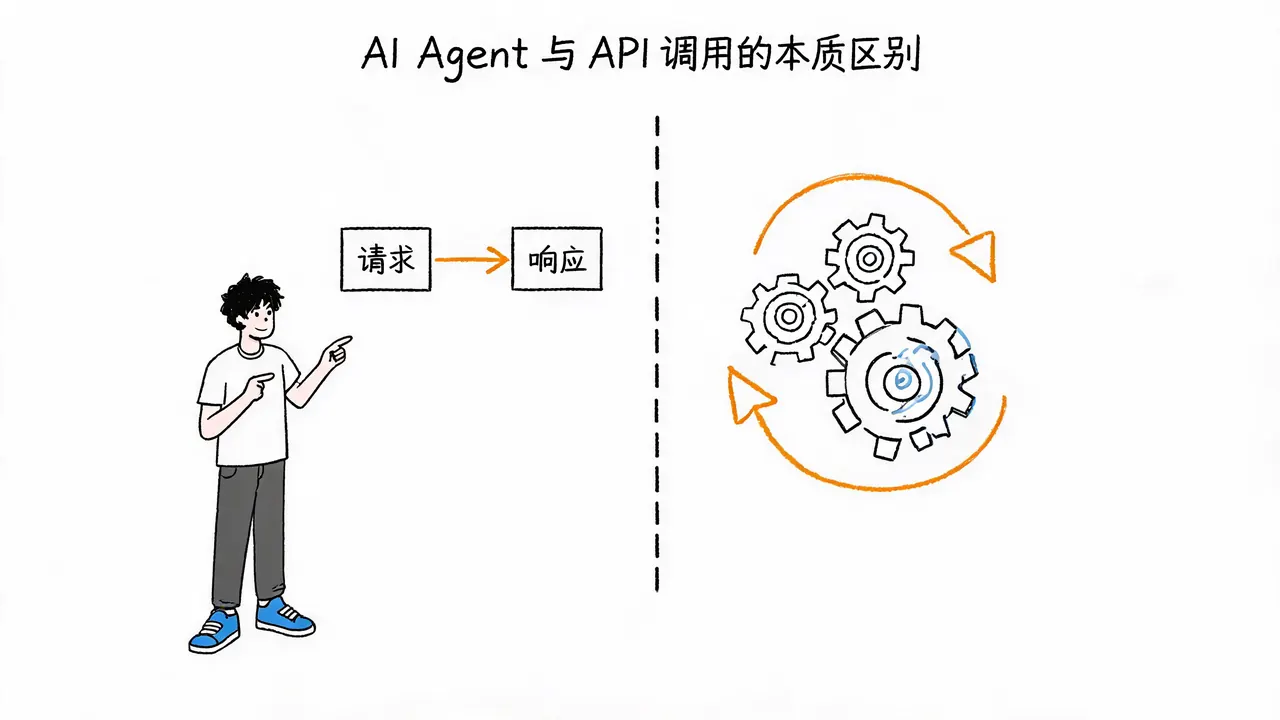
接入大模型 API 不等于拥有 AI Agent。本文深入解析 Agent 的目标驱动特性、五大核心组件及执行闭环,对比普通 API 调用的差异,并探讨成本、错误累积及安全边界等工程约束,帮助开发者正确理解并构建可靠的智能体系统。
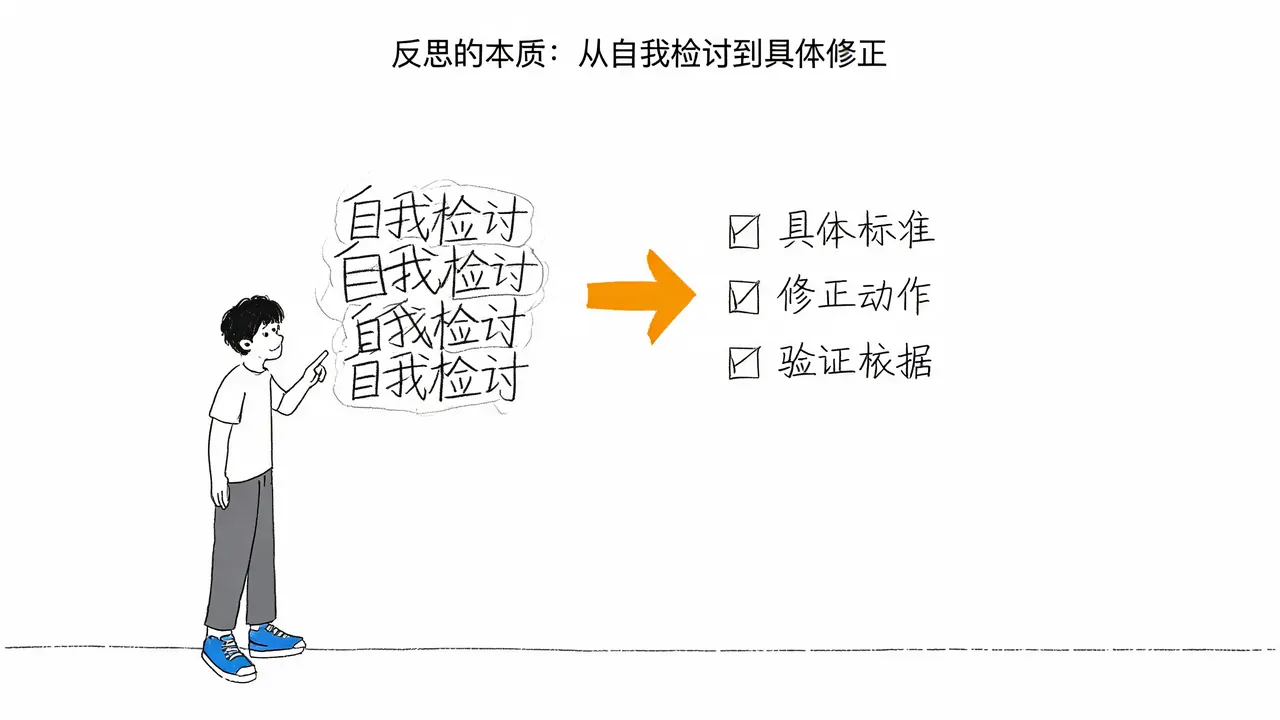
大模型常出现“诚恳道歉但答案依旧错误”的现象,这是因为缺乏外部验证的反思往往只是换种说法。本文探讨如何在系统中分离自我评价与外部验证,通过设定具体验收标准、引入客观证据及明确停止条件,构建受约束的纠错流程。
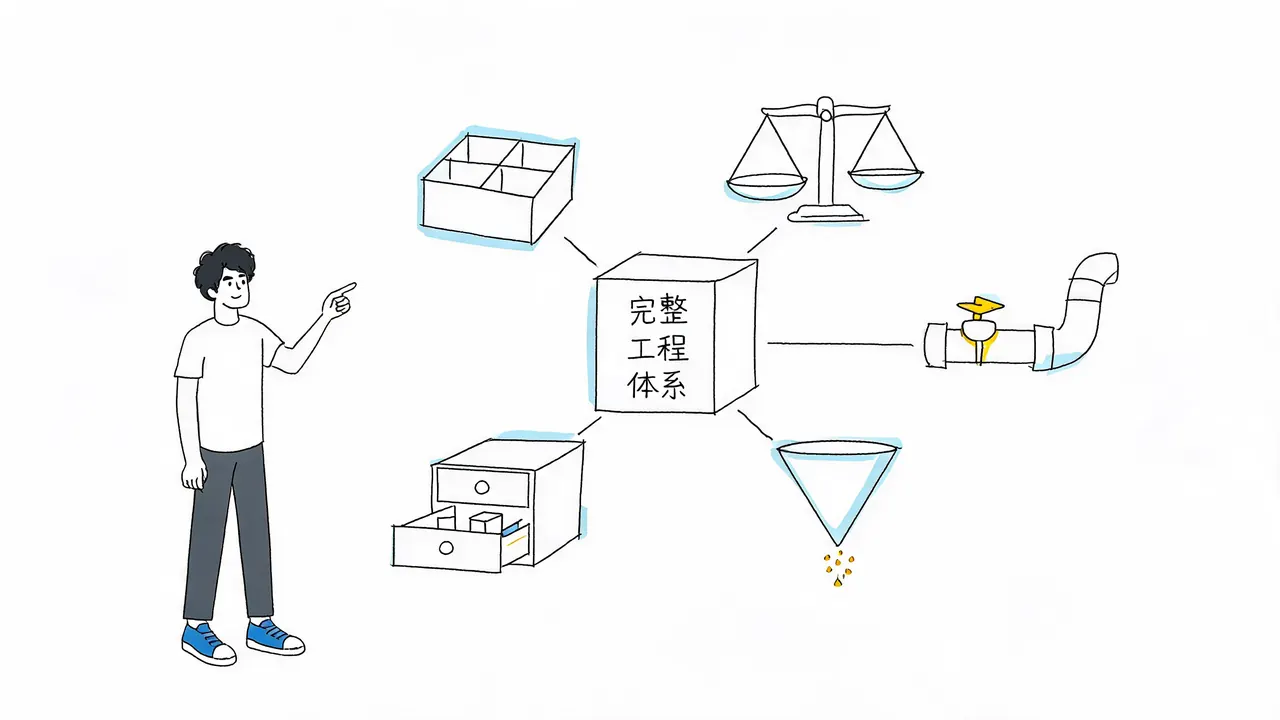
在 AI Agent 工具调用中,简单的重试循环可能导致重复扣款等严重事故。本文深入解析超时重试的工程链路,涵盖错误分类、幂等校验、状态回查、局部补偿及熔断机制,帮助开发者构建安全可控的智能体执行系统。
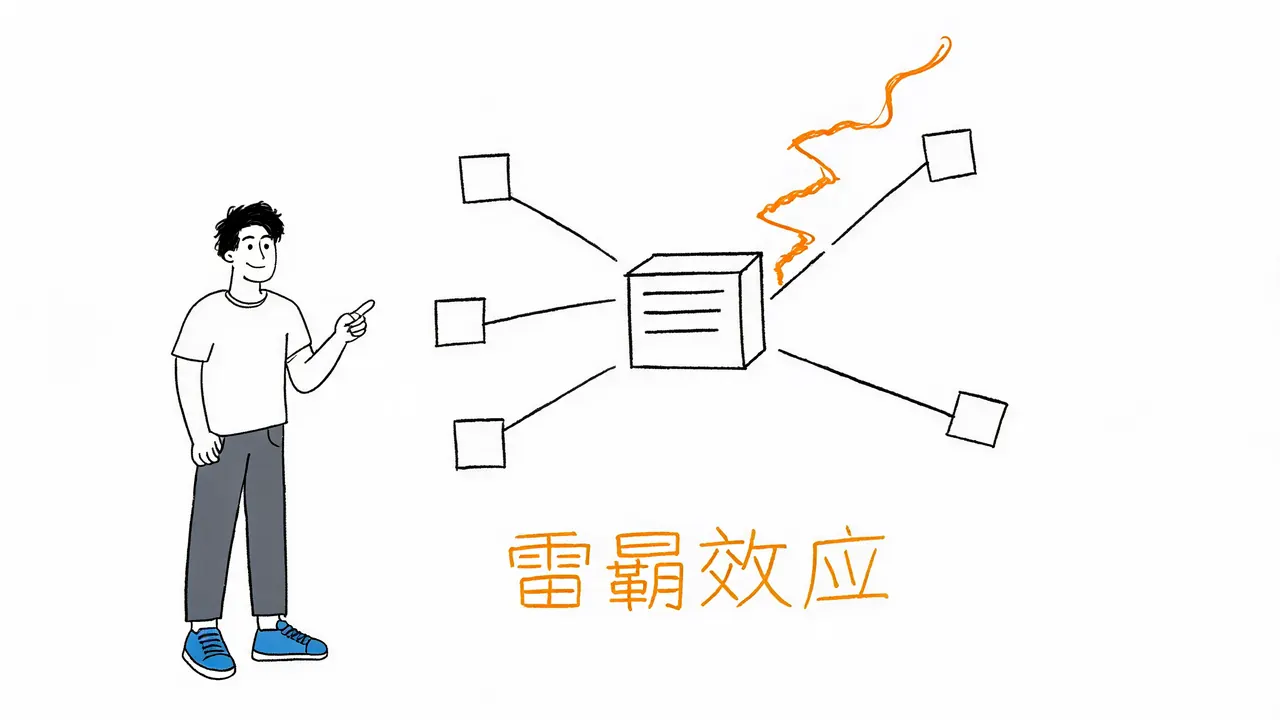
深入解析慢 SQL 如何通过耗尽连接池、榨干 CPU 与磁盘资源、引发锁竞争三大机制拖垮数据库。理解其破坏原理,掌握预防雪崩的关键策略。
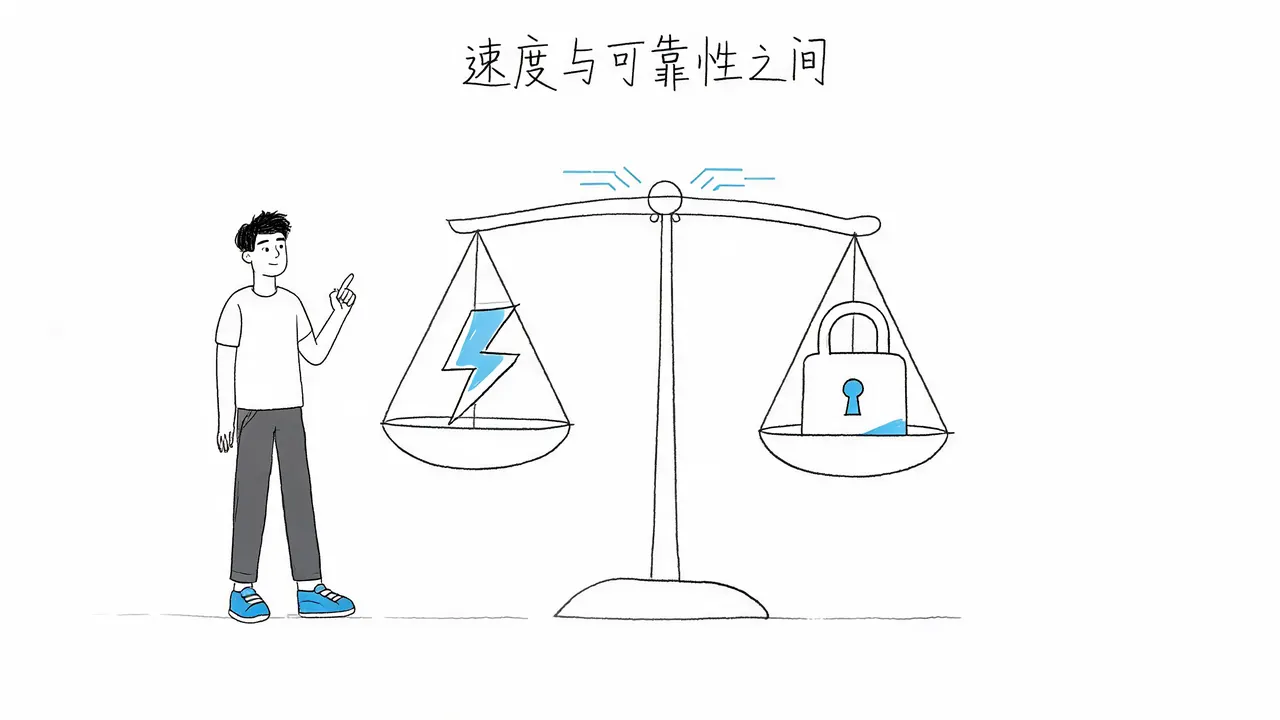
支付成功后页面未刷新或订单状态更新延迟,并非故障,而是系统为了保证资金安全与数据一致性所做的工程选择。本文深入解析支付链路中的异步通知机制、重试策略、幂等性设计及主动查询方案,帮助开发者理解背后的消息处理逻辑。