上下文工程 vs 提示词工程:从“写指令”到“管信息环境”
上下文工程并非提示词工程的改名,而是围绕上下文窗口的系统设计。本文解析两者在单次调用与多轮系统、指令表达与信息编排上的核心差异,并介绍上下文工程的四道工序及五大常见陷阱。
共 6 篇文章
上下文工程并非提示词工程的改名,而是围绕上下文窗口的系统设计。本文解析两者在单次调用与多轮系统、指令表达与信息编排上的核心差异,并介绍上下文工程的四道工序及五大常见陷阱。
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
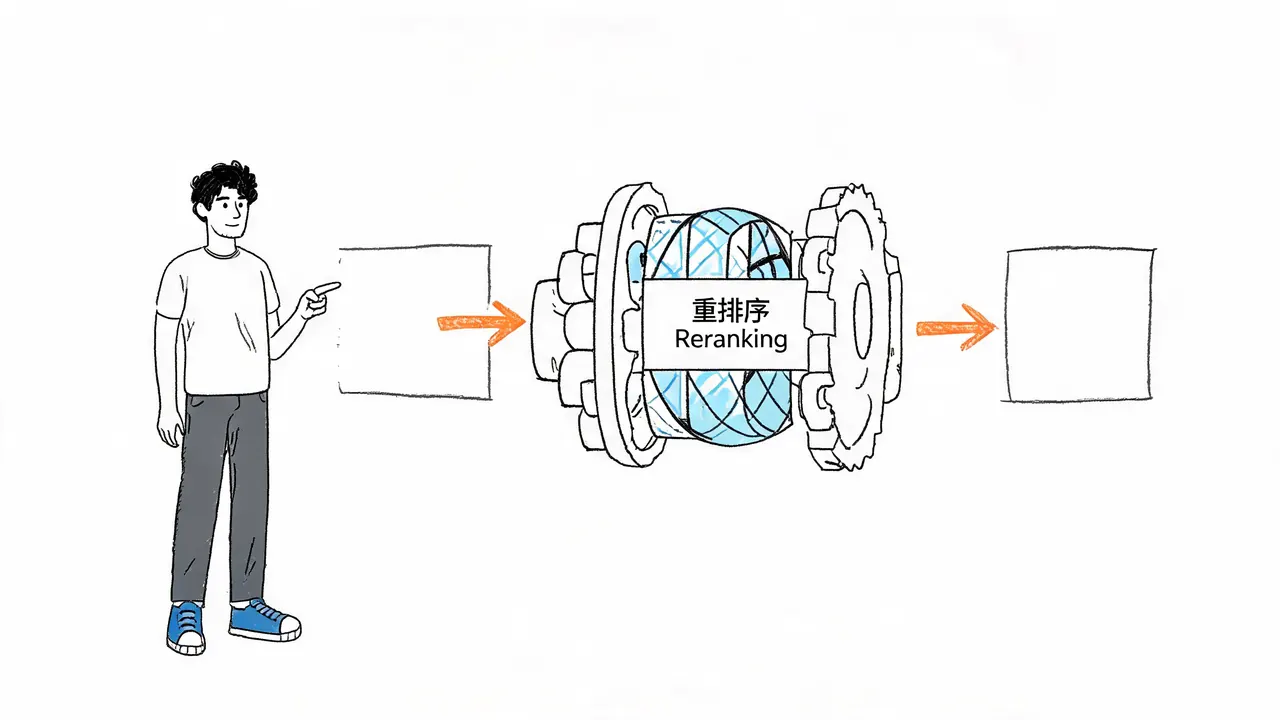
在 RAG 系统中,检索成功但答案不准往往源于重排序环节。本文解析重排序在召回与生成之间的关键位置,对比向量与关键词检索的盲区,阐述交叉编码器原理,并明确其受限于召回率、切分质量及算力成本的三大边界。
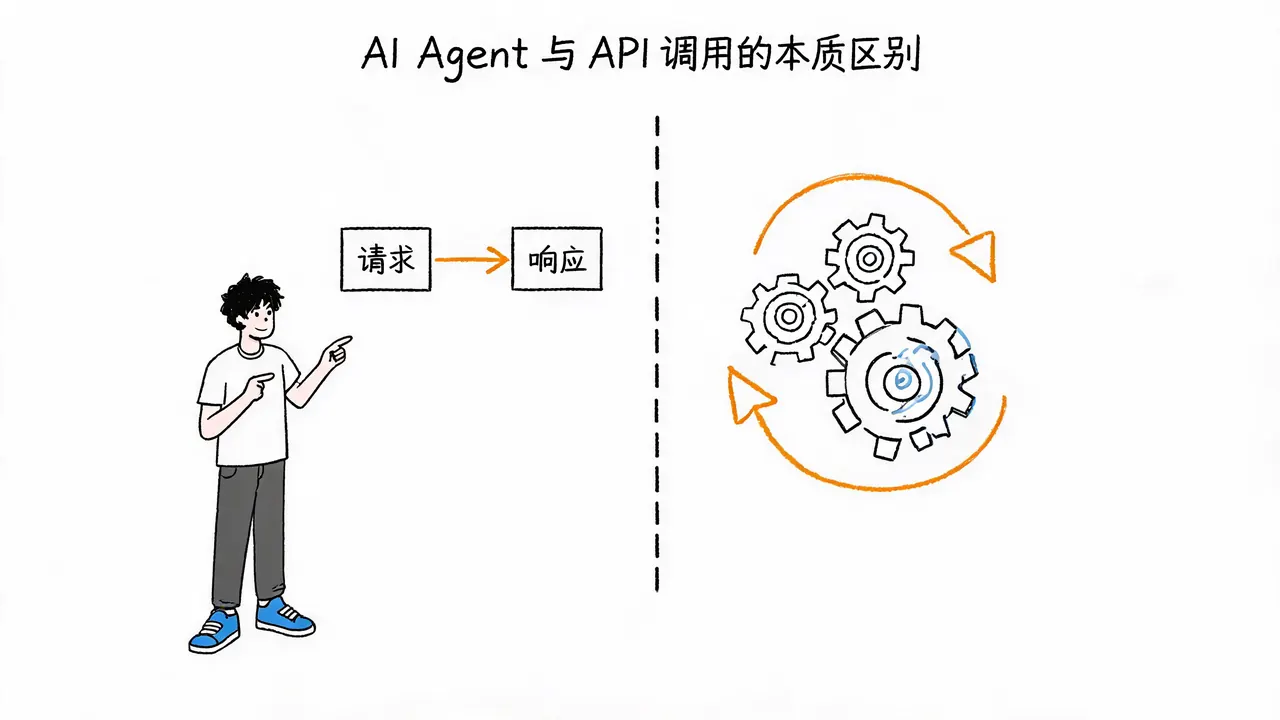
接入大模型 API 不等于拥有 AI Agent。本文深入解析 Agent 的目标驱动特性、五大核心组件及执行闭环,对比普通 API 调用的差异,并探讨成本、错误累积及安全边界等工程约束,帮助开发者正确理解并构建可靠的智能体系统。
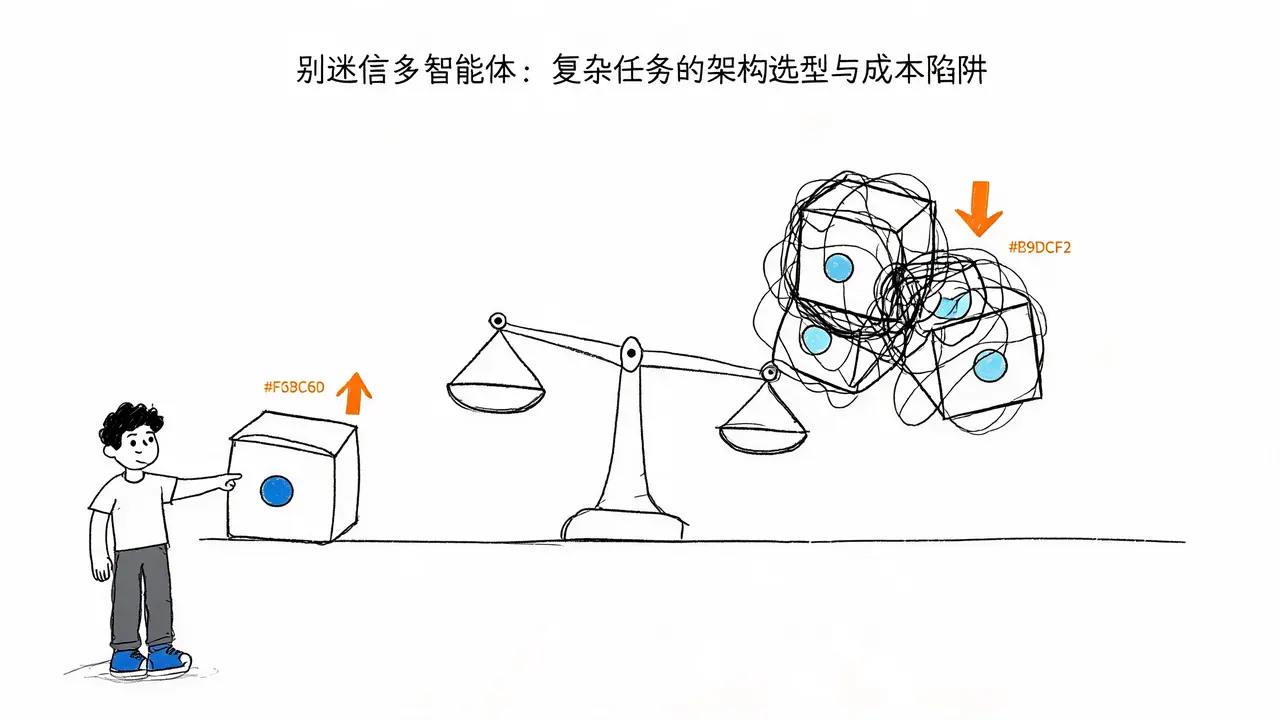
深入解析多智能体架构的适用边界。通过系统日志分析,揭示为何强行拆分深度串联任务会导致系统变慢和 Token 消耗剧增,并给出基于耗时、成本和通信日志的选型决策指南。
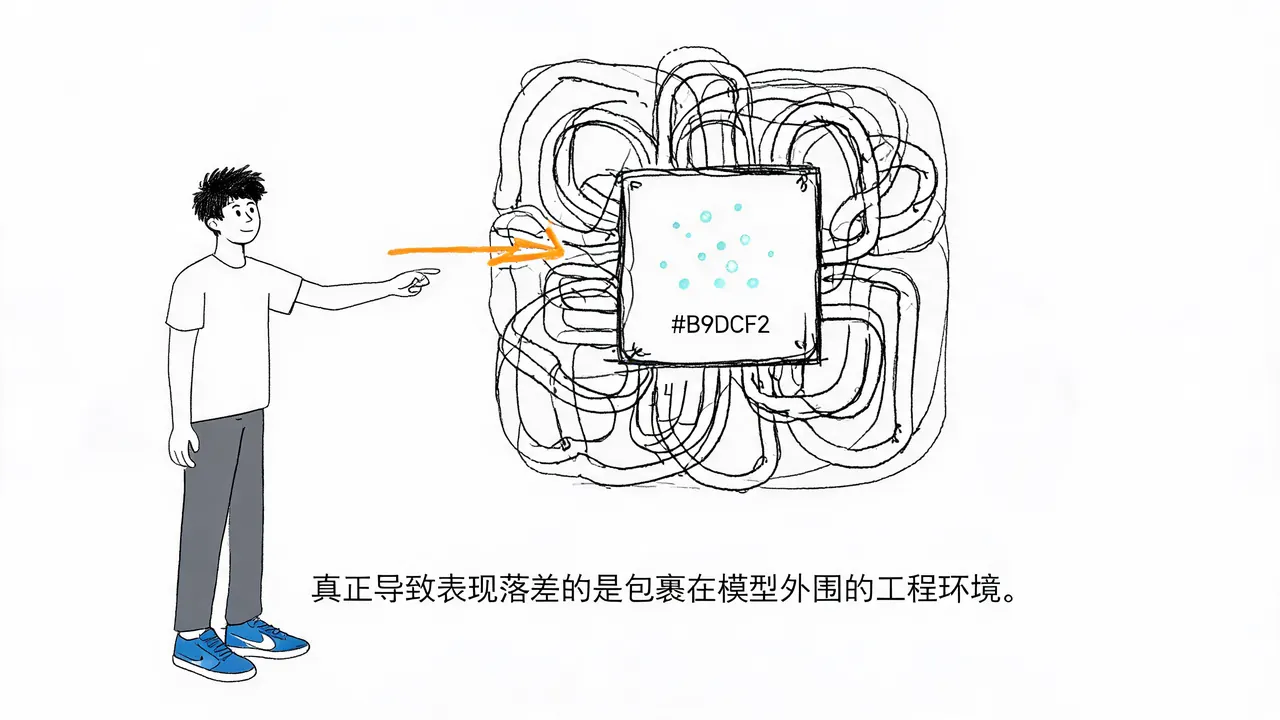
为什么 AI 模型在测试环境表现优异,上线后却频繁出错?本文深入解析 Harness Engineering(工程外壳)的概念,揭示上下文装配、工具管理及错误处理对 Agent 表现的关键影响,并提供基于运行链路的系统性排查策略。