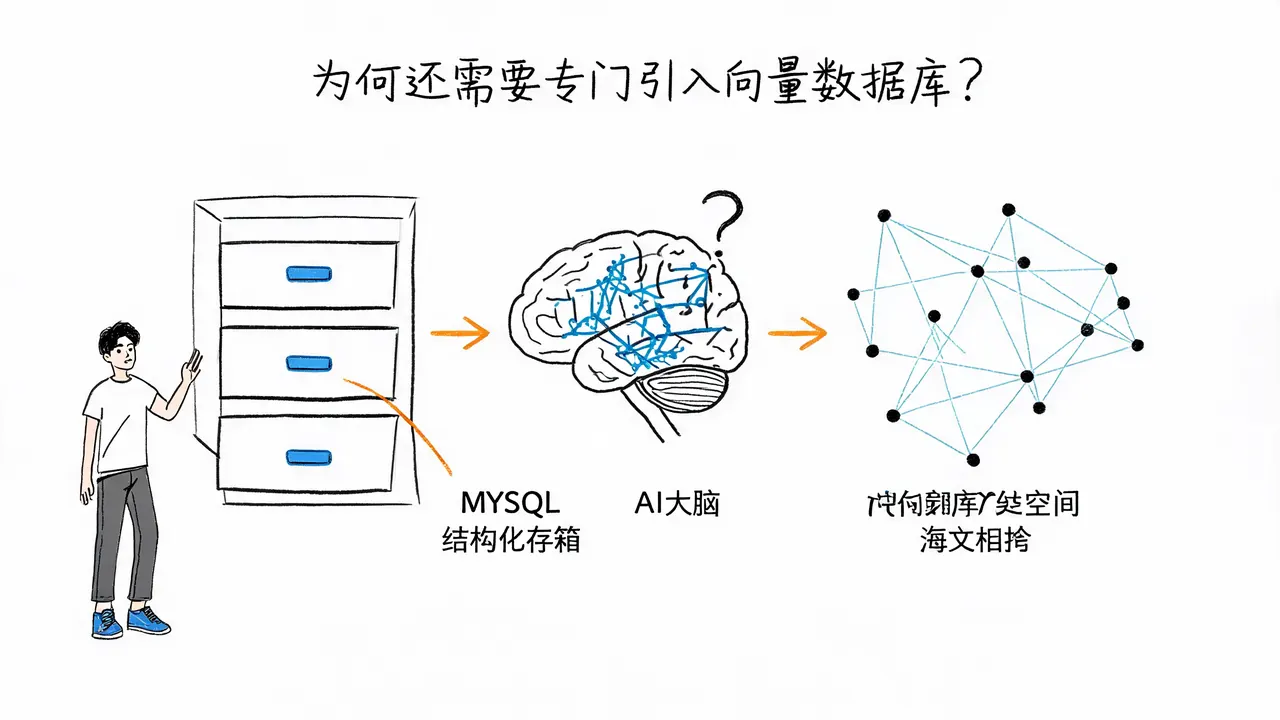
有了MySQL,为什么AI还需要向量数据库?
深入解析MySQL与向量数据库的核心差异。MySQL擅长结构化数据的精确查询,而向量数据库通过Embedding和ANN算法,专为AI时代的语义检索和非结构化数据处理而生。了解两者如何分工协作,构建现代AI应用的数据底座。
共 17 篇文章
深入解析MySQL与向量数据库的核心差异。MySQL擅长结构化数据的精确查询,而向量数据库通过Embedding和ANN算法,专为AI时代的语义检索和非结构化数据处理而生。了解两者如何分工协作,构建现代AI应用的数据底座。
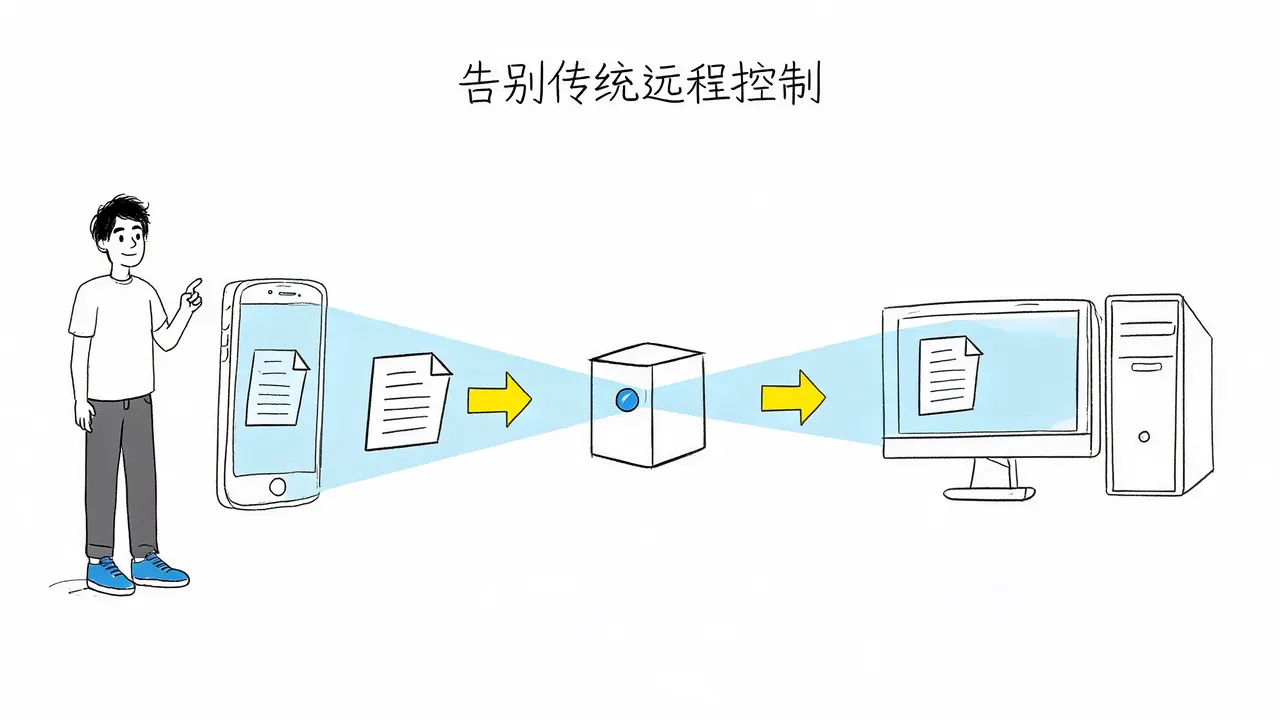
本文实测豆包工作独立端,展示其如何通过 AI 实现跨端文件查找与格式转换。无需传统远程桌面,即可在手机端轻松处理电脑文件,体验更高效的智能工作流。
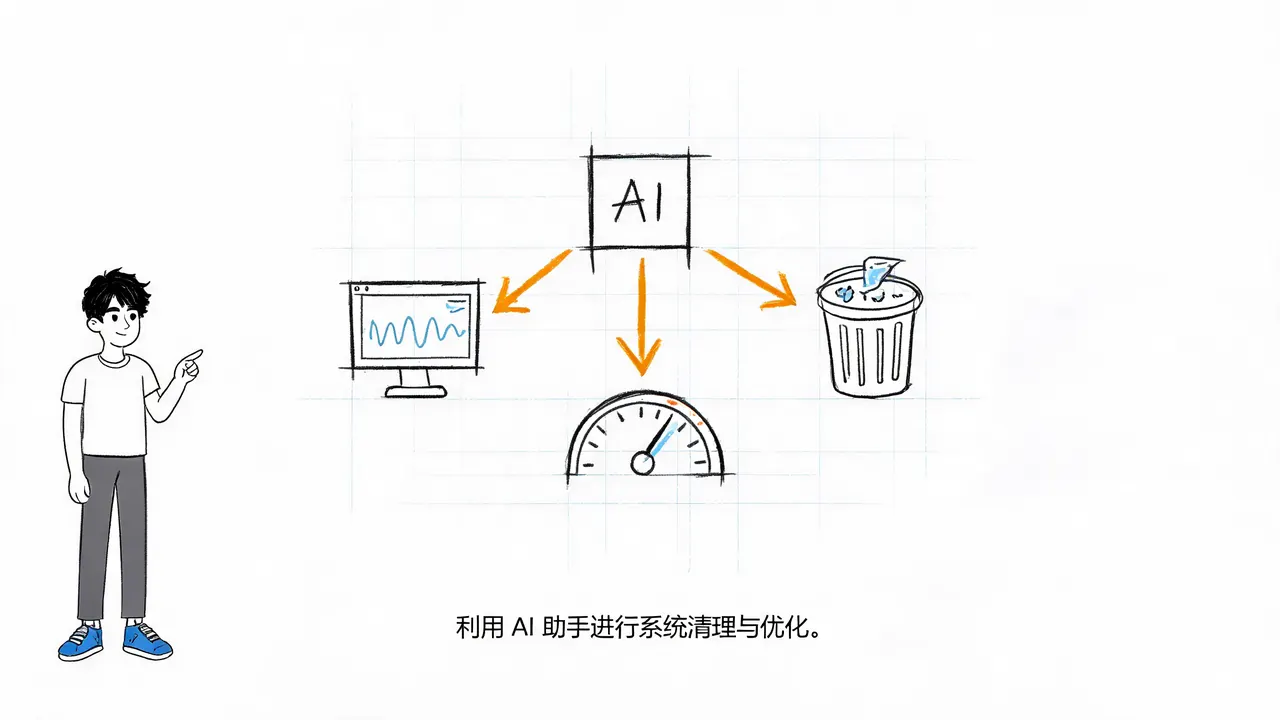
电脑越用越卡怎么办?本文介绍如何利用豆包AI的“系统清理与优化助手”技能,通过自动化扫描、可视化图表分析及风险分级,安全高效地清理C盘垃圾与大文件,解决电脑卡顿问题。
深入解析AI大模型的本质:它并非拥有意识的超级大脑,而是基于海量数据和千亿级参数的巨型神经网络。本文从神经网络结构、训练数据、涌现能力等角度,科普大模型的工作原理及其对未来的影响。
深度解析字节跳动推出的免费AI编程工具TRAE。涵盖IDE与Solo双模式、Skills技能包功能及国际版限时免费活动,助力开发者实现从需求到部署的全流程智能化。
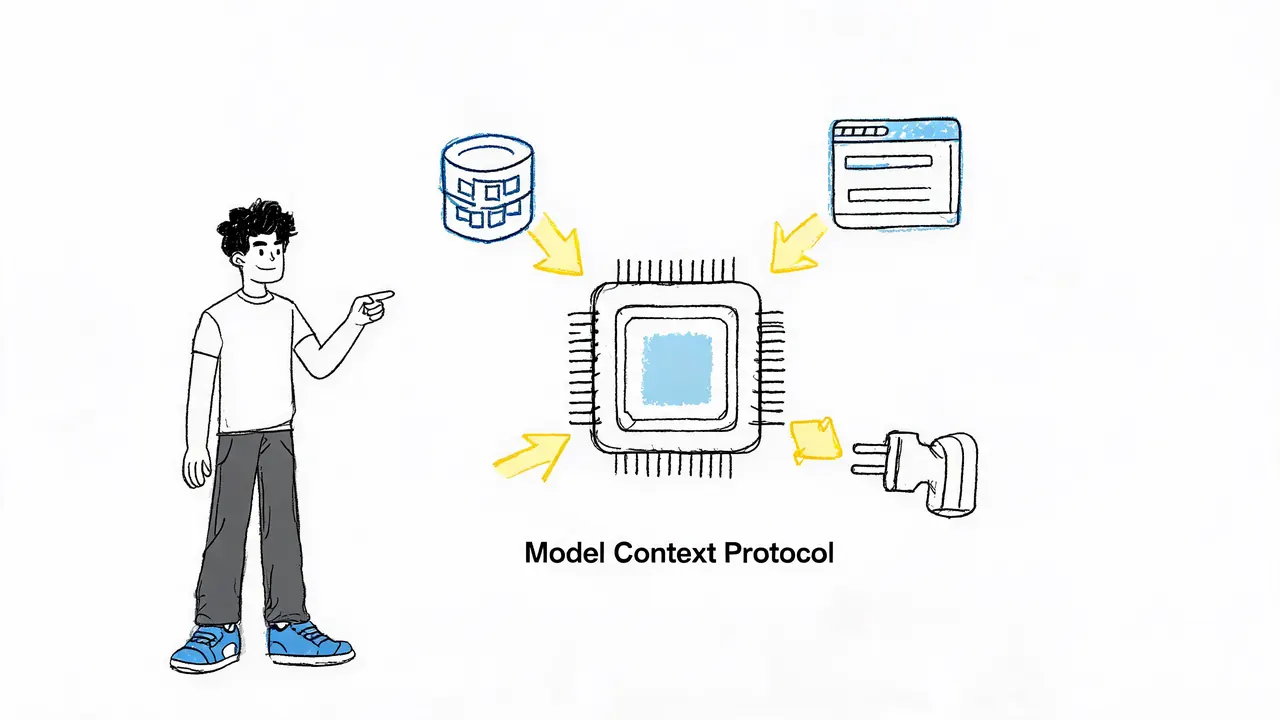
深入解析由 Anthropic 发起的 MCP(模型上下文协议)。了解它如何像 USB 接口一样统一 AI 模型与外部数据、工具的通信标准,解决适配难题,推动 AI 从“能聊天”走向“能干活”。
深入解析 Agent Skills 开放标准,对比其与 MCP 的区别。了解 Skills 的文件夹结构、核心优势及如何赋予 AI 真正的执行力,实现从连接到操作的跨越。
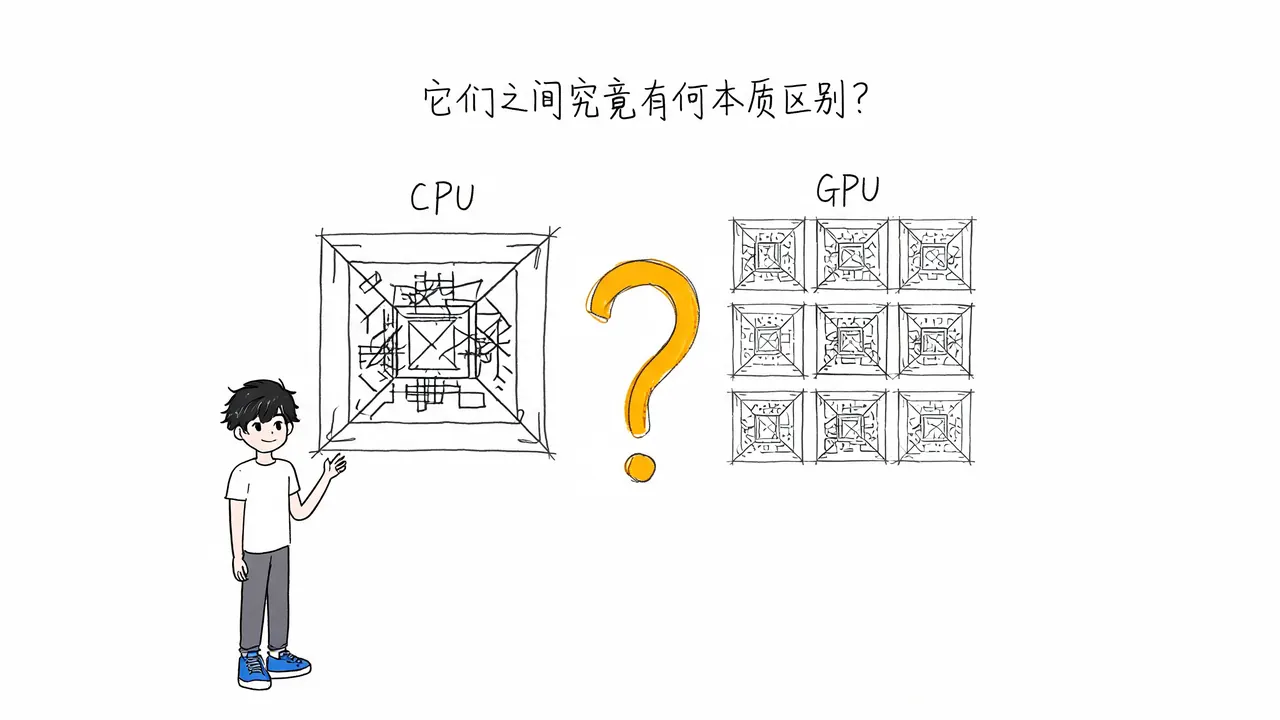
深入解析GPU(图形处理器)与CPU(中央处理器)的本质区别。通过生动的比喻,阐述GPU在并行计算、图形渲染及人工智能领域的核心优势,以及两者如何协同工作。
深入解析Token在计算机领域的两种含义,重点阐述AI大模型中语言Token的工作原理、上下文窗口限制及计费机制,并提供五大实用技巧帮助开发者优化Prompt、降低API调用成本。
面对AI生成代码的冲击,程序员职业是否面临消失?本文解析2026年开发者的转型关键:从单纯编码转向AI编排,掌握智能体工程,深耕垂直领域,实现从执行者到工程师的价值跃迁。
旧金山初创公司 Eon Systems 成功将果蝇大脑完整数字化,实现无代码预设的自主行为。这一突破标志着从大脑模拟跨越至大脑仿真,引发关于数字生命权利及人类是否身处虚拟世界的深刻思考。

分享豆包 AI 的两个进阶使用技巧:利用语音通话功能辅助读书笔记整理与主题阅读扩展,以及使用同声传译功能解决海外点餐等场景的语言障碍,提升学习与生活效率。