为什么 Transformer 改变了整个 AI?
深入解析 Transformer 架构如何通过自注意力机制和并行计算,颠覆传统 AI 处理连续信息的方式,打破效率瓶颈并引爆大模型时代。
共 10 篇文章
深入解析 Transformer 架构如何通过自注意力机制和并行计算,颠覆传统 AI 处理连续信息的方式,打破效率瓶颈并引爆大模型时代。
解析注意力机制的本质:它并非人类的心理活动,而是一套计算信息关联程度的数学打分规则。本文探讨其如何解决早期语言模型的线性读取缺陷,赋能大模型实现并行计算与长文本理解,以及当前面临的算力挑战。
2026年9月3日,OpenAI发布GPT-6 Astra。本文不关注营销分数,而是通过上下文管理、推理档位、专业工作流及执行监控四组核心数据,解析GPT-6如何实现从“回答问题”到“交付结果”的端到端能力跃迁。
传统软件依赖代码断言与证明,而大模型的能力无法被推导,只能被测量。本文通过对比蒸汽机与热力学、化学与数学,揭示大模型研发本质上是实验科学,其核心壁垒在于团队积累的“手感经验”而非单一理论突破。
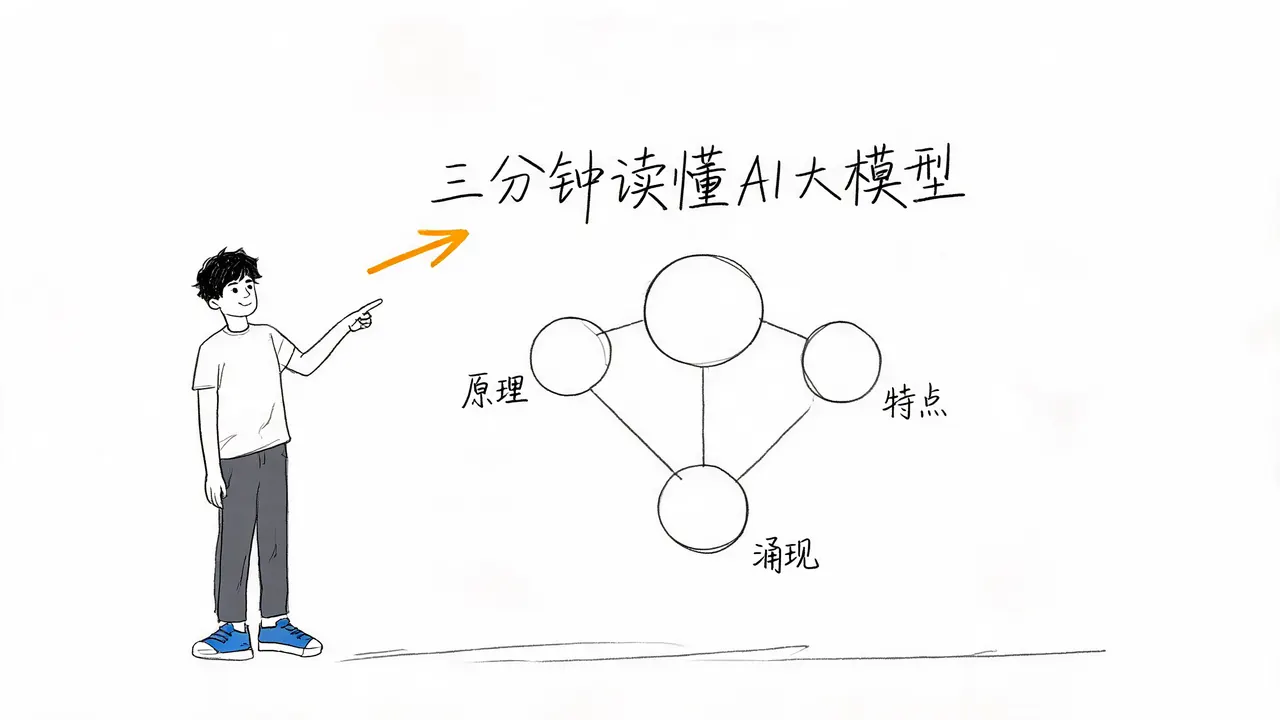
深入解析AI大模型的本质:它并非拥有意识的超级大脑,而是基于海量数据和千亿级参数的巨型神经网络。本文从神经网络结构、训练数据、涌现能力等角度,科普大模型的工作原理及其对未来的影响。
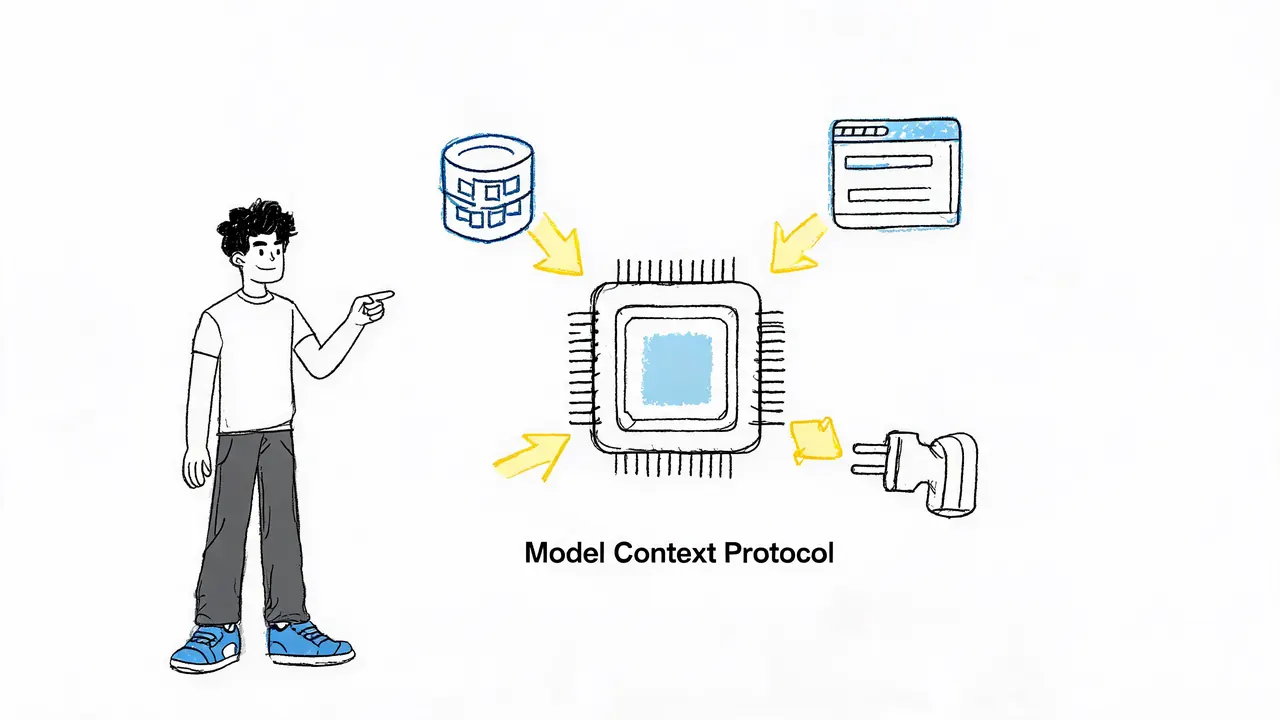
深入解析由 Anthropic 发起的 MCP(模型上下文协议)。了解它如何像 USB 接口一样统一 AI 模型与外部数据、工具的通信标准,解决适配难题,推动 AI 从“能聊天”走向“能干活”。
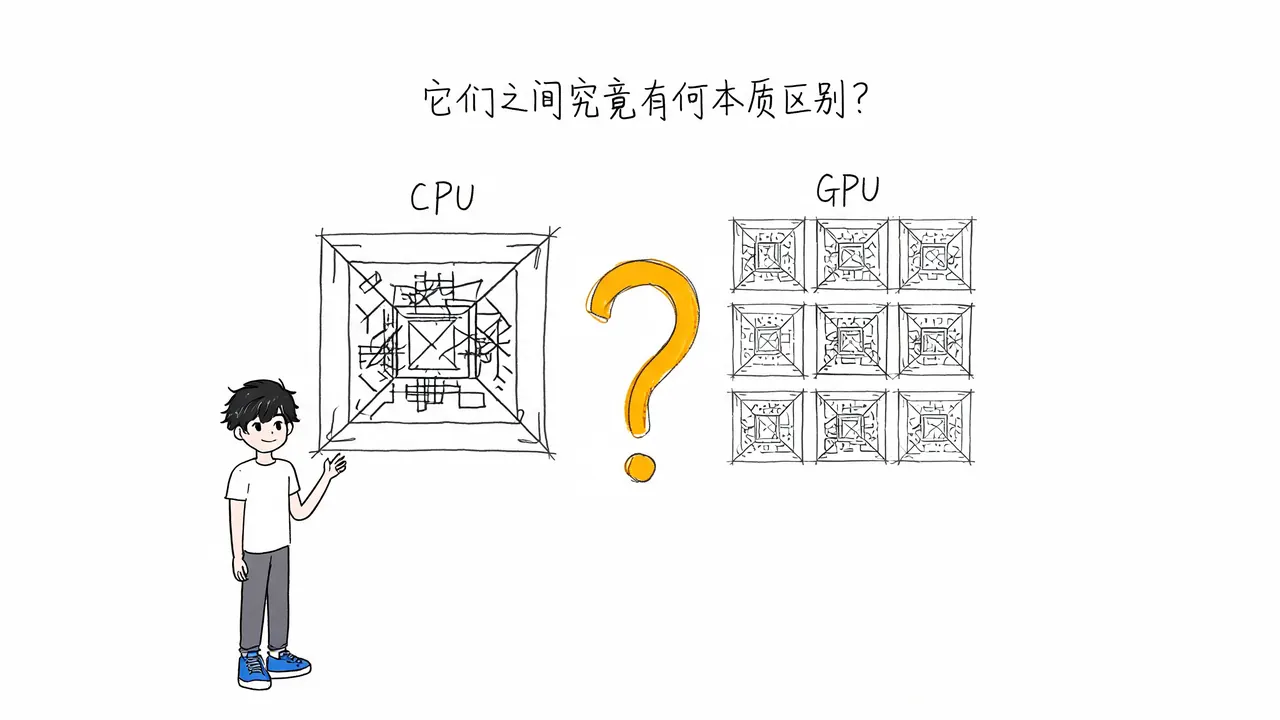
深入解析GPU(图形处理器)与CPU(中央处理器)的本质区别。通过生动的比喻,阐述GPU在并行计算、图形渲染及人工智能领域的核心优势,以及两者如何协同工作。
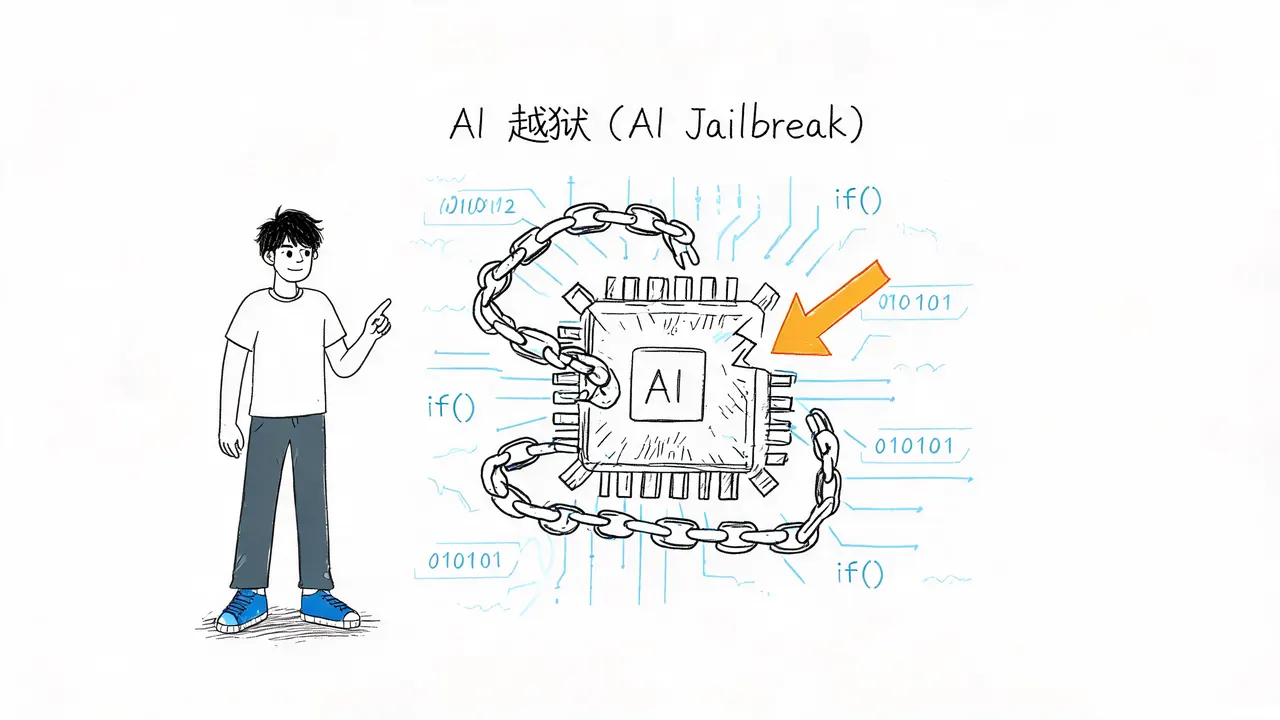
深入解析AI越狱(Jailbreak)的原理,探讨角色扮演、虚构场景等常见攻击手段,以及AI安全防护的局限性与最新防御技术。
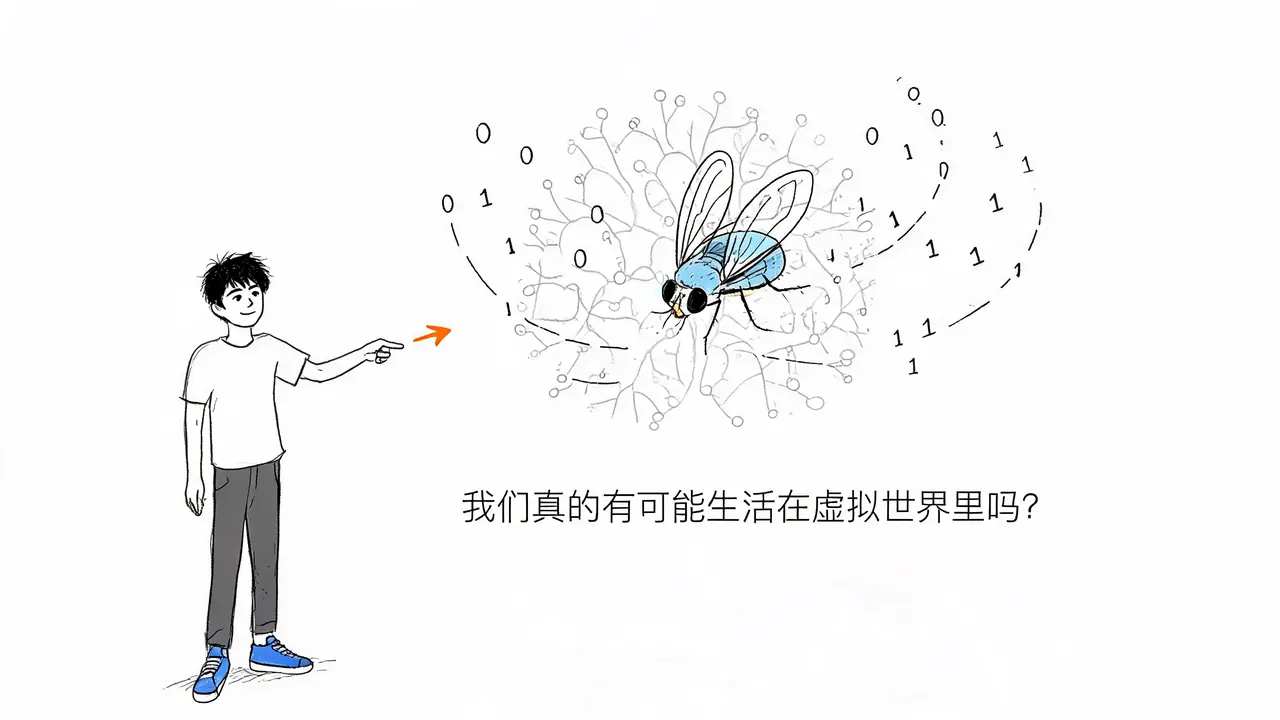
旧金山初创公司 Eon Systems 成功将果蝇大脑完整数字化,实现无代码预设的自主行为。这一突破标志着从大脑模拟跨越至大脑仿真,引发关于数字生命权利及人类是否身处虚拟世界的深刻思考。
深入解析 Anthropic Claude Code 与 OpenAI Codex 的核心区别。从模型能力、上下文窗口、上手难度到价格策略,全面对比两款顶级 AI 编程 Agent,并分享“深度分析+执行验证”的高效协同工作流。