线上频繁 Full GC 排查指南:从命令执行到体系化治理
本文深入解析生产环境频繁 Full GC 的排查逻辑,涵盖在线无侵入诊断、慢泄漏溯源、参数调优及流量突增应急方案,帮助后端工程师构建体系化的 JVM 治理思维。
共 10 篇文章
本文深入解析生产环境频繁 Full GC 的排查逻辑,涵盖在线无侵入诊断、慢泄漏溯源、参数调优及流量突增应急方案,帮助后端工程师构建体系化的 JVM 治理思维。
线上 Redis 爆机通常表现为 CPU 飙高、内存溢出、带宽跑满或连接爆满。本文解析 Redis 单线程模型下的瓶颈原理,提供基于监控指标的排查步骤,并给出替换 KEYS 命令、配置内存淘汰策略及治理大 Key 的具体优化方案。
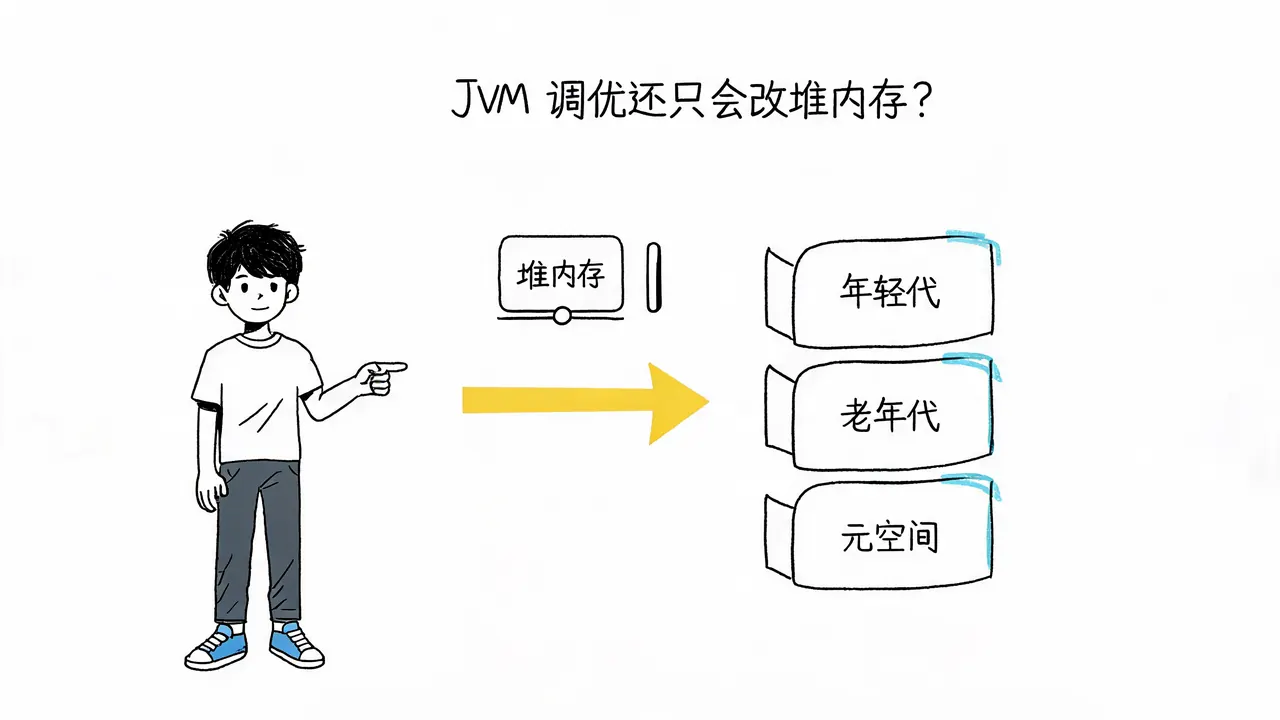
本文通过一个真实的面试案例,剖析了将 JVM 调优简单等同于“加大堆内存”的常见误区。文章深入阐述了从问题定位、代码优化到回收器选择的系统化调优思路,帮助开发者掌握大厂面试官看重的底层原理与工程化思维。
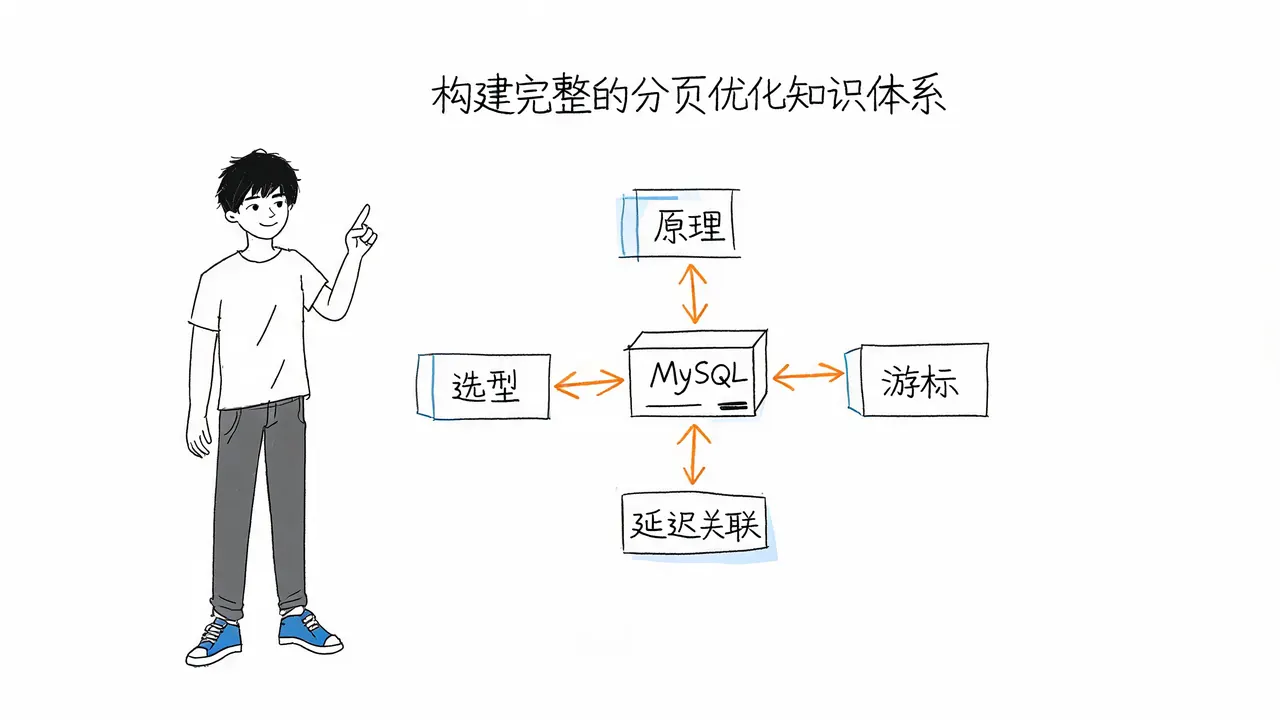
深入剖析 MySQL 深分页性能瓶颈,对比 ID 游标法与延迟关联方案的适用边界,提供从底层原理到架构选型的完整优化策略,助力后端开发者应对高级面试与生产环境挑战。
本文通过一个真实的线上服务假死案例,深入剖析线程池配置背后的隐性风险。从业务分级、监控熔断到架构优化,构建三层防御体系,解决线程池集体卡死难题,提升后端高并发稳定性。
当系统拆分为大量微服务后,传统局部日志排障彻底失效。本文深入解析链路追踪的核心机制(TraceID与Span),阐述其如何解决故障定位难、性能瓶颈隐蔽等问题,并探讨适用场景与性能权衡。
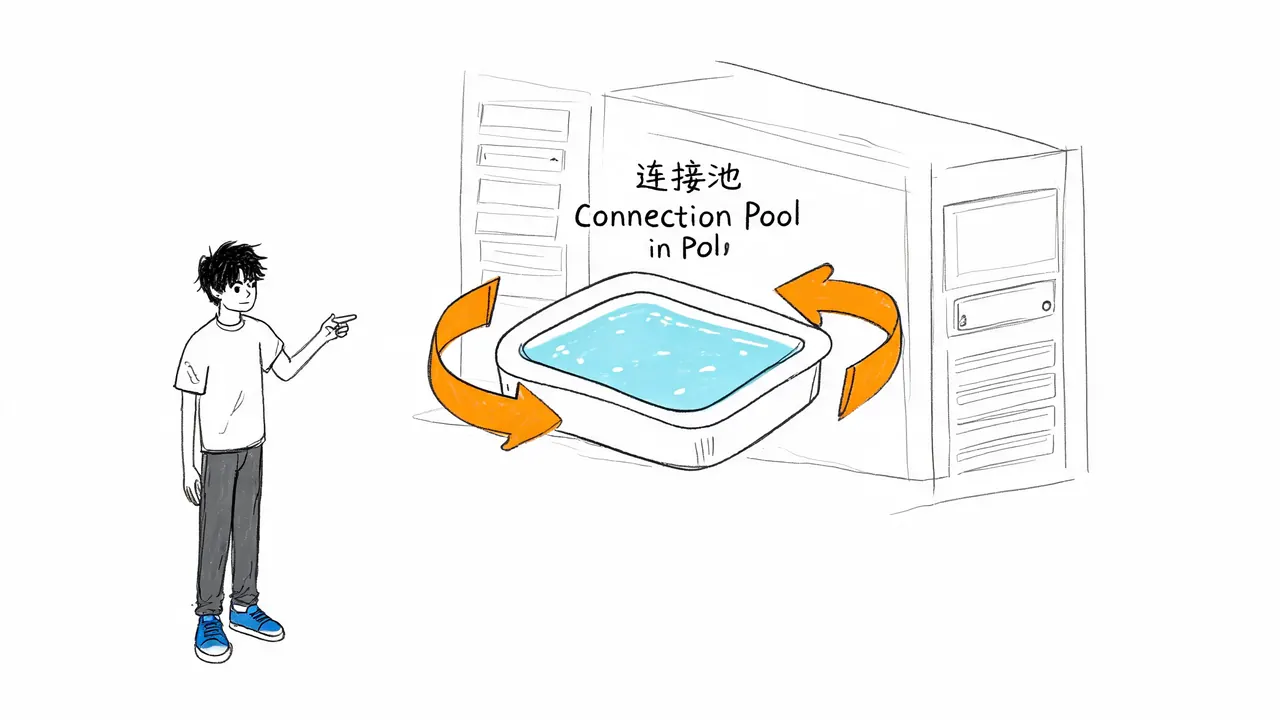
深入解析数据库连接池的工作原理,揭示为何不能随意新建连接。本文通过银行窗口类比,讲解连接复用机制、连接泄漏的危害及排查信号,帮助开发者避免数据库崩溃。
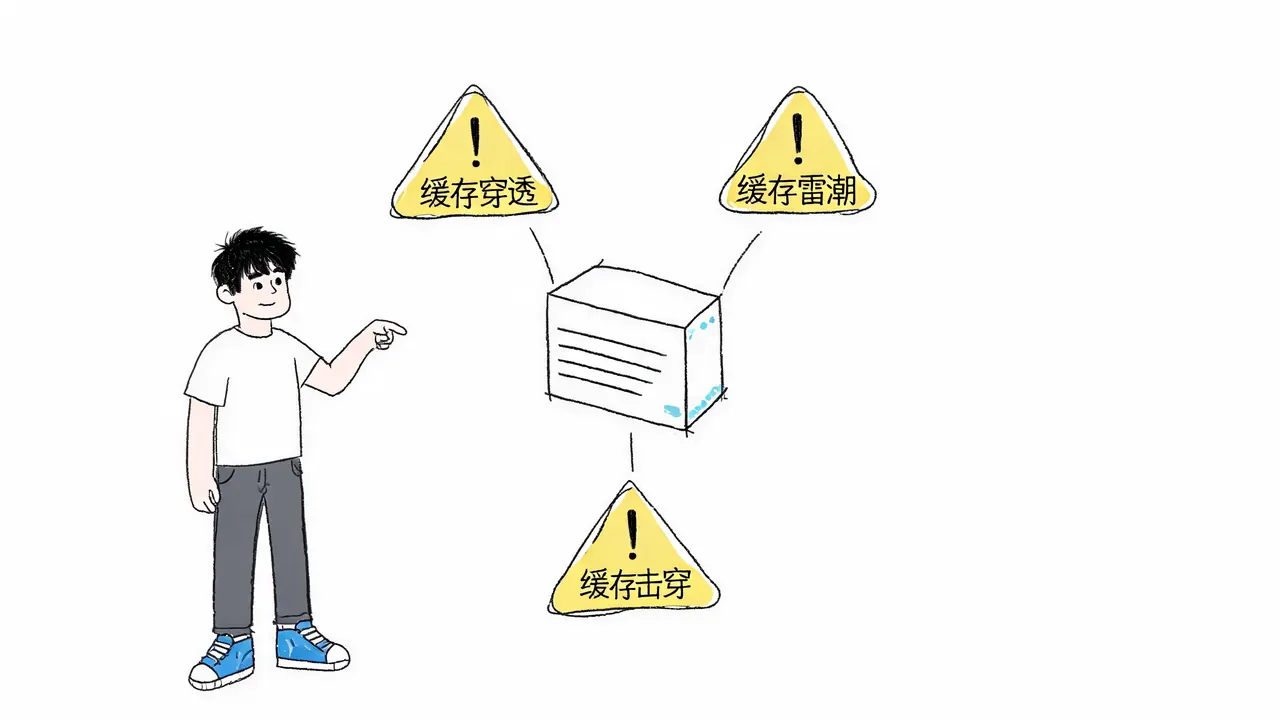
缓存加得好能提速,加不好可能把数据库压垮。本文深入解析缓存穿透、缓存雪崩和缓存击穿这三个常见陷阱,并提供具体的解决方案,帮助开发者避免系统崩溃。
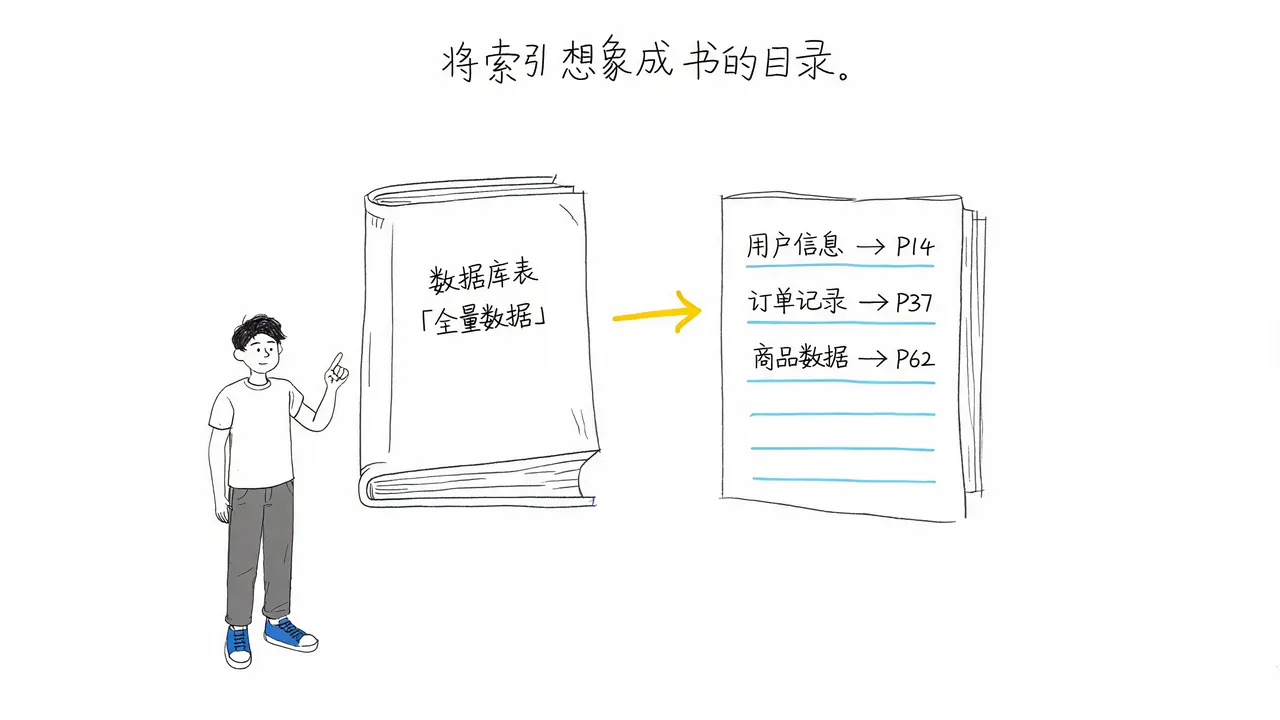
数据量从百条增至百万条,查询为何变慢?本文通过“目录”类比,深入浅出地讲解数据库索引的原理、适用场景及常见误区,帮助开发者避免全表扫描,提升查询效率。
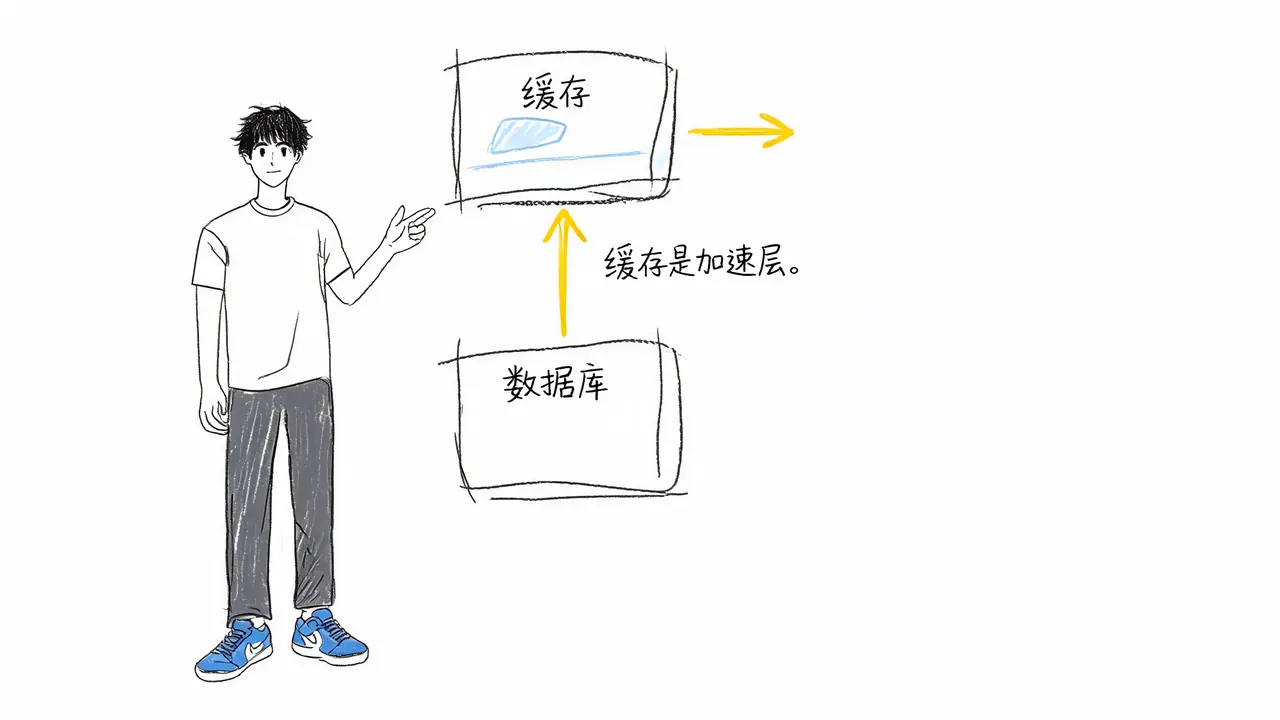
为什么缓存比数据库快?本文解析缓存与数据库的核心区别,探讨缓存的适用场景、数据一致性挑战及 Redis 的基础概念,帮助零基础开发者理解缓存作为加速层的本质。