Redis哨兵机制详解:主节点宕机后的自动故障转移流程
深入解析Redis哨兵模式的工作原理,包括主观与客观下线判断、Leader选举机制以及基于四层漏斗的新主节点筛选策略,揭示如何实现秒级自动故障恢复。
共 13 篇文章
深入解析Redis哨兵模式的工作原理,包括主观与客观下线判断、Leader选举机制以及基于四层漏斗的新主节点筛选策略,揭示如何实现秒级自动故障恢复。
深入解析 Redis 分布式锁的可靠性问题,探讨默认实现的风险、看门狗机制与 Redlock 算法的增强方案,以及如何在生产环境中通过工程权衡实现高可用并发控制。
深入解析 Redis 哨兵机制的工作原理,包括心跳检测、主观与客观下线判断、自动故障转移流程,以及其在数据分片和脑裂场景下的能力边界。
本文深入解析分布式定时任务在集群脑裂、节点宕机、任务重叠及积压等场景下的可靠性设计。通过调度层仲裁、执行层幂等、超时检测及分级隔离策略,构建生产级的高可用定时任务体系,帮助后端工程师应对复杂生产环境挑战。
本文通过一个真实的重复支付事故案例,深入剖析接口幂等性在并发场景下的失效原因。提出业务分级、兜底校验与架构优化三层防御体系,帮助后端工程师构建高可靠的幂等保障方案,避免线上资损。
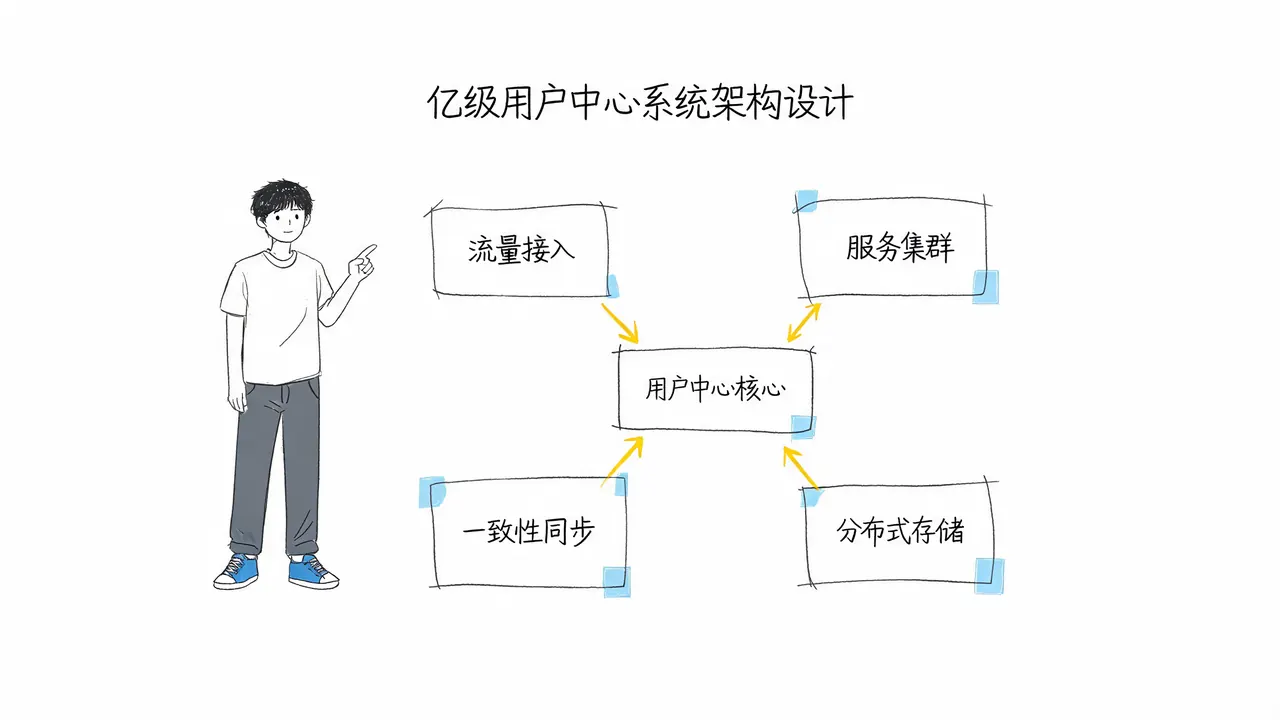
本文深入解析一道大厂后端 P7 级高频面试题:如何设计支持亿级用户体量的用户中心系统。文章从流量分层、服务拆分、存储体系、一致性保障、多集群协同及安全成本六个维度,拆解高可用、高并发分布式架构的核心得分点,帮助开发者构建完整的架构思维。
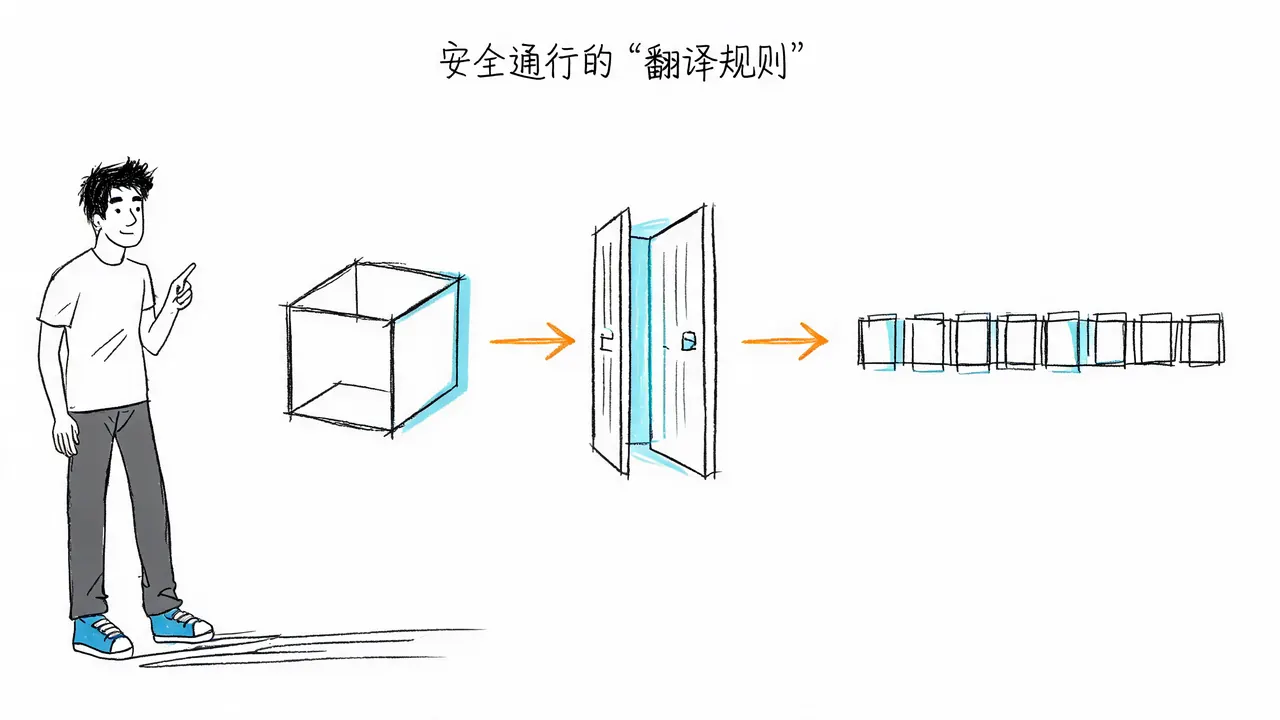
深入解析 Java 序列化与反序列化的核心原理,探讨对象为何无法直接存储或传输,介绍 Serializable 接口、ObjectOutputStream 的使用,以及 transient 关键字和序列化版本号在解决敏感数据过滤与版本兼容性中的关键作用。
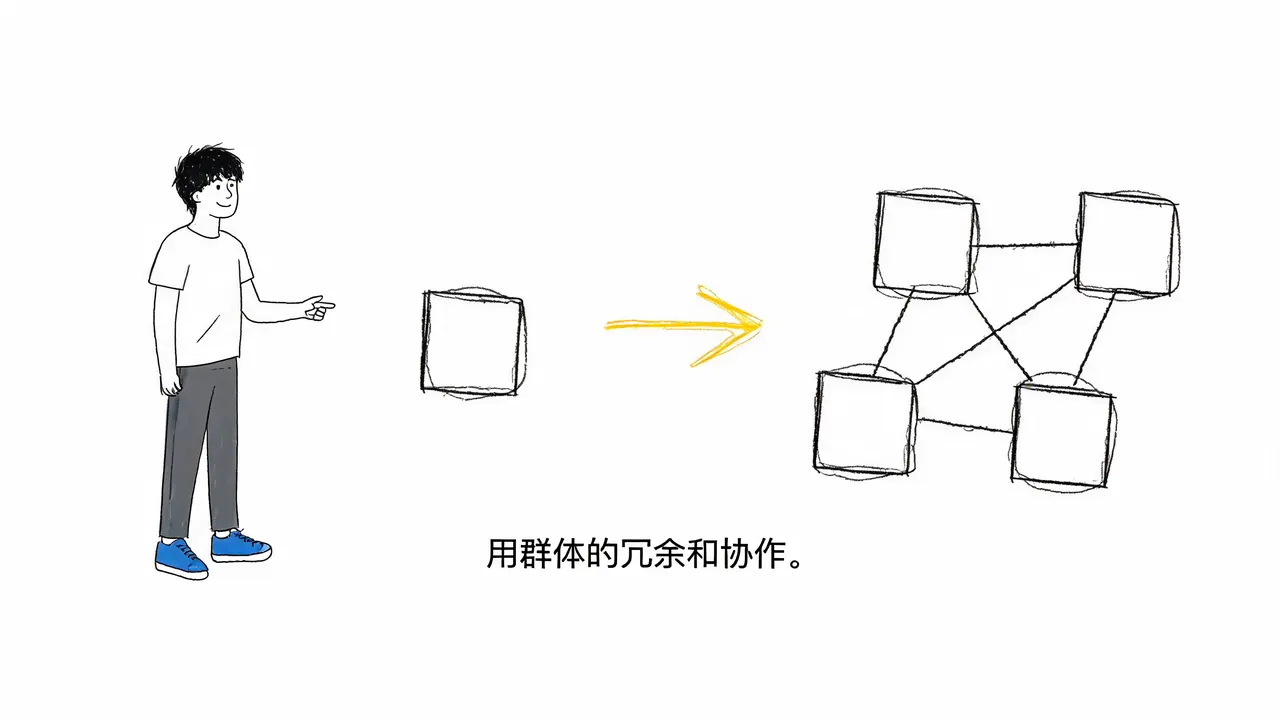
单机Kafka虽具备百万级吞吐量,但在面对海量数据存储、单点故障风险及高并发读写时存在物理极限。本文深入解析Kafka集群如何通过分区、副本机制及水平扩展打破单机瓶颈,实现高可用与高性能。
深入解析Redis脑裂现象:从网络隔离到哨兵误判,揭示双主共存导致数据丢失的根本原因,并探讨最小从节点写入限制等防御机制。
当系统拆分为大量微服务后,传统局部日志排障彻底失效。本文深入解析链路追踪的核心机制(TraceID与Span),阐述其如何解决故障定位难、性能瓶颈隐蔽等问题,并探讨适用场景与性能权衡。
深入解析 Kafka 的核心概念、高性能原理及高可靠性设计。了解为何阿里、字节等巨头将其作为处理海量实时数据的“中央数据总线”,以及生产者在现代互联网架构中的关键作用。
深入解析分布式系统的核心思想。从任务并行化、数据分片化到去中心化管理,探讨如何通过多台机器协作突破单机瓶颈,构建高可用、弹性伸缩的现代互联网架构。