RAG 答不准?可能是文本切分(Chunking)做错了
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
共 7 篇文章
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
在 RAG 系统中,检索成功但答案不准往往源于重排序环节。本文解析重排序在召回与生成之间的关键位置,对比向量与关键词检索的盲区,阐述交叉编码器原理,并明确其受限于召回率、切分质量及算力成本的三大边界。
深入解析混合检索(Hybrid Search)的核心原理,探讨如何通过向量检索与关键词检索的双路召回及融合排序,解决单一检索方式在语义理解和精确匹配上的局限性,提升 RAG 系统的召回鲁棒性。
解决 RAG 系统中 PDF 解析导致表头丢失、图片缺失及出处不可追溯的问题。本文从工程角度拆解文档处理逻辑,涵盖分流策略、表格与图表处理、OCR 置信度管理及错误归因评测,确保大模型问答的证据链保真。
RAG 系统回答正确不代表系统可靠。本文拆解 RAG 评测的三层逻辑:数据检索、模型生成与业务层,介绍如何通过“中间真值”定位故障层级,避免盲目调参或换模型,实现快速精准修复。
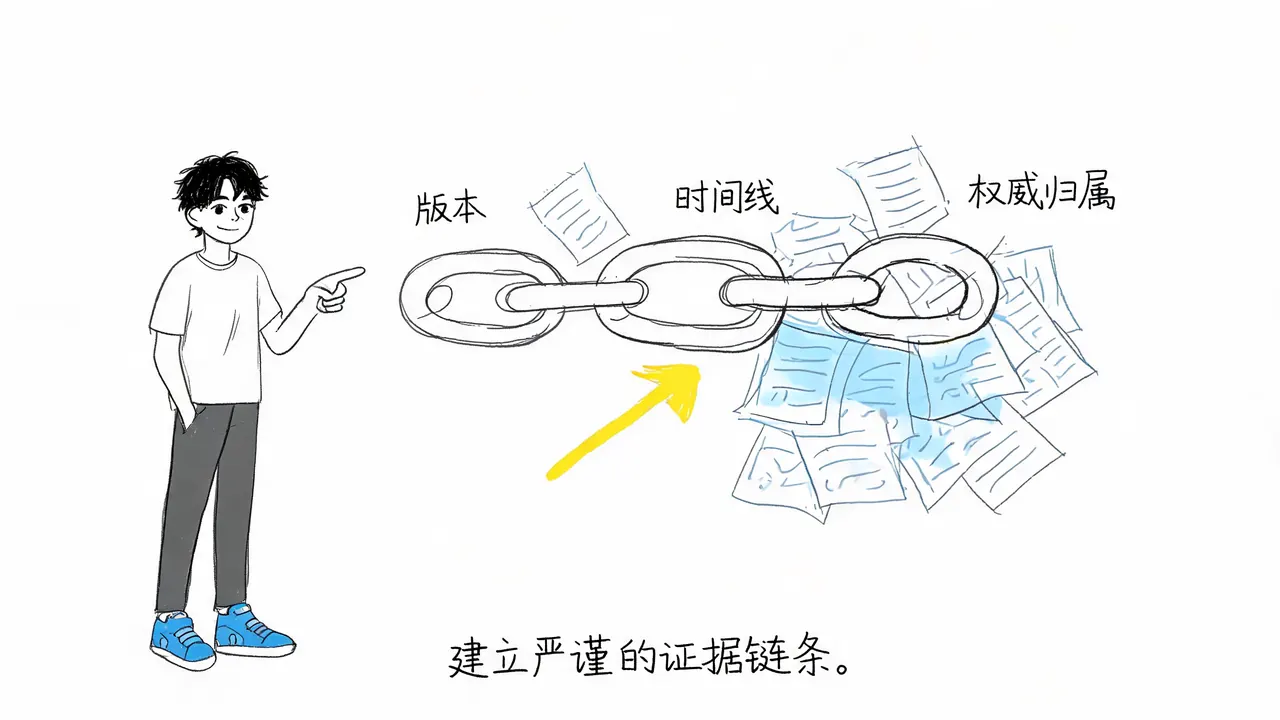
当大模型面对最新文档与过期权威手册的冲突时,往往生成“缝合怪”答案。本文从工程视角拆解检索矛盾处理链路,通过元数据优先级、意图路由及人工介入机制,构建可靠的证据链条。
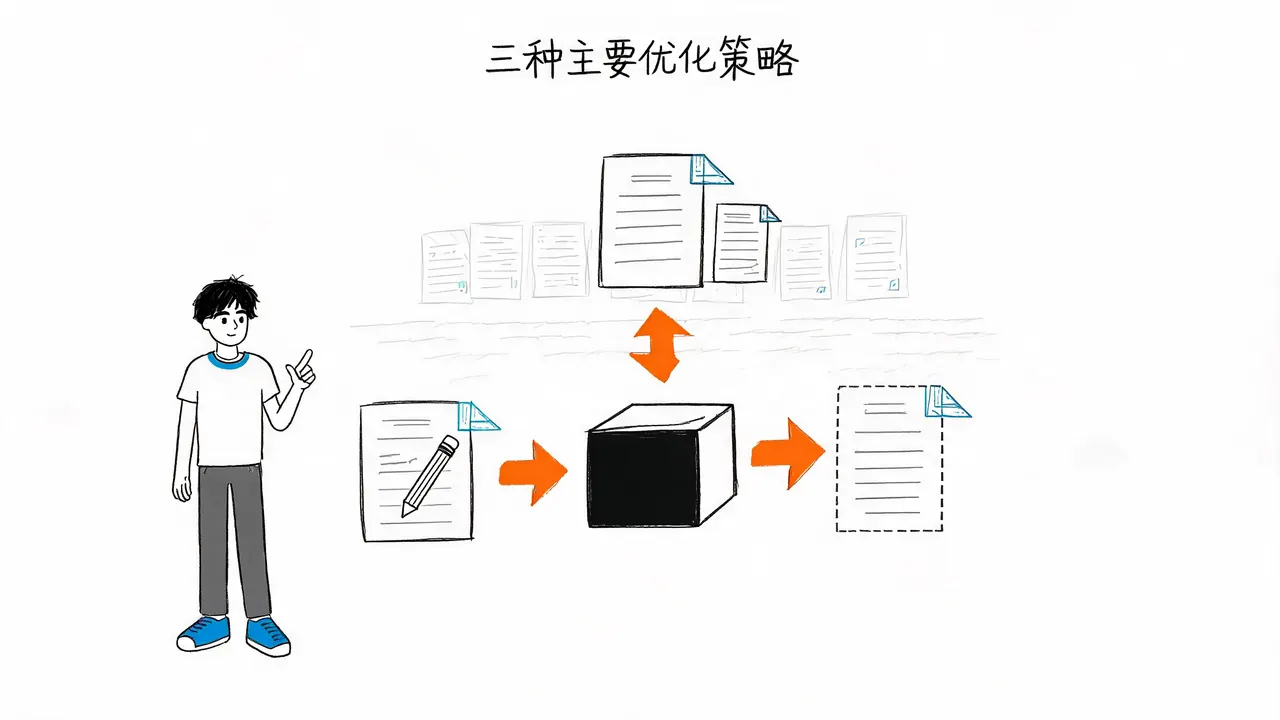
在使用大模型时遇到检索不准的问题?本文深入解析查询改写、拆分子问题和 HyDE 三种常见的检索优化策略,探讨它们各自解决的缺口、适用场景及潜在风险,帮助开发者根据实际需求选择合适的优化方案。