什么是注意力机制?为什么大模型离不开它?
解析注意力机制的本质:它并非人类的心理活动,而是一套计算信息关联程度的数学打分规则。本文探讨其如何解决早期语言模型的线性读取缺陷,赋能大模型实现并行计算与长文本理解,以及当前面临的算力挑战。
共 12 篇文章
解析注意力机制的本质:它并非人类的心理活动,而是一套计算信息关联程度的数学打分规则。本文探讨其如何解决早期语言模型的线性读取缺陷,赋能大模型实现并行计算与长文本理解,以及当前面临的算力挑战。
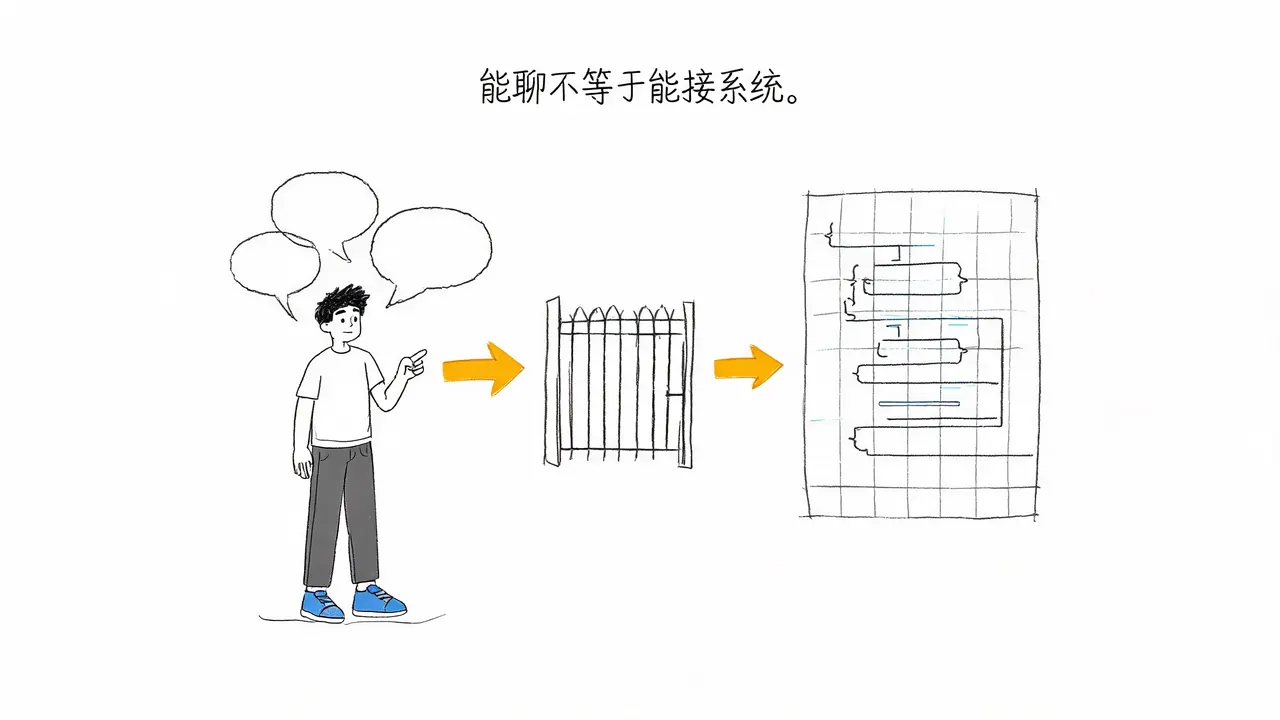
大模型能生成流畅文本不代表能稳定接入业务系统。本文解析结构化输出的核心定义,阐述通过提示词、Schema 及解码约束实现稳定 JSON 输出的三层方法,并强调解析校验与业务规则兜底的重要性,指出格式稳定不等于内容正确。
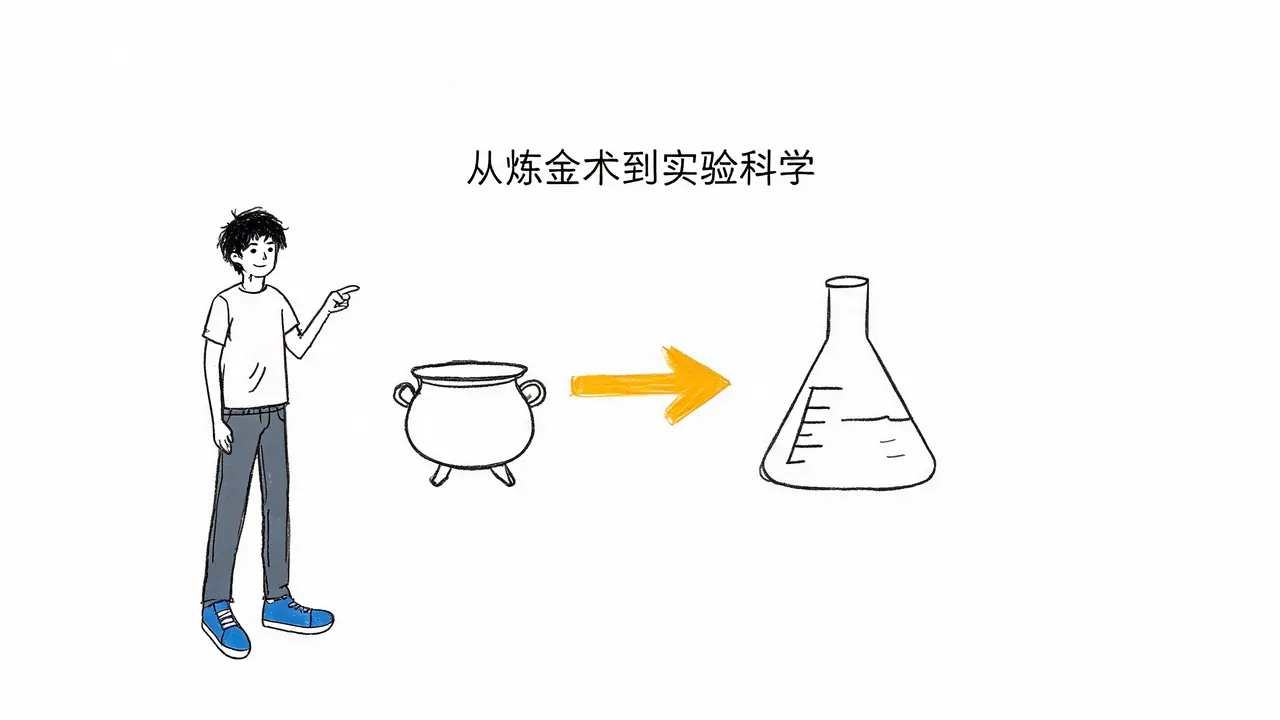
传统软件依赖代码断言与证明,而大模型的能力无法被推导,只能被测量。本文通过对比蒸汽机与热力学、化学与数学,揭示大模型研发本质上是实验科学,其核心壁垒在于团队积累的“手感经验”而非单一理论突破。
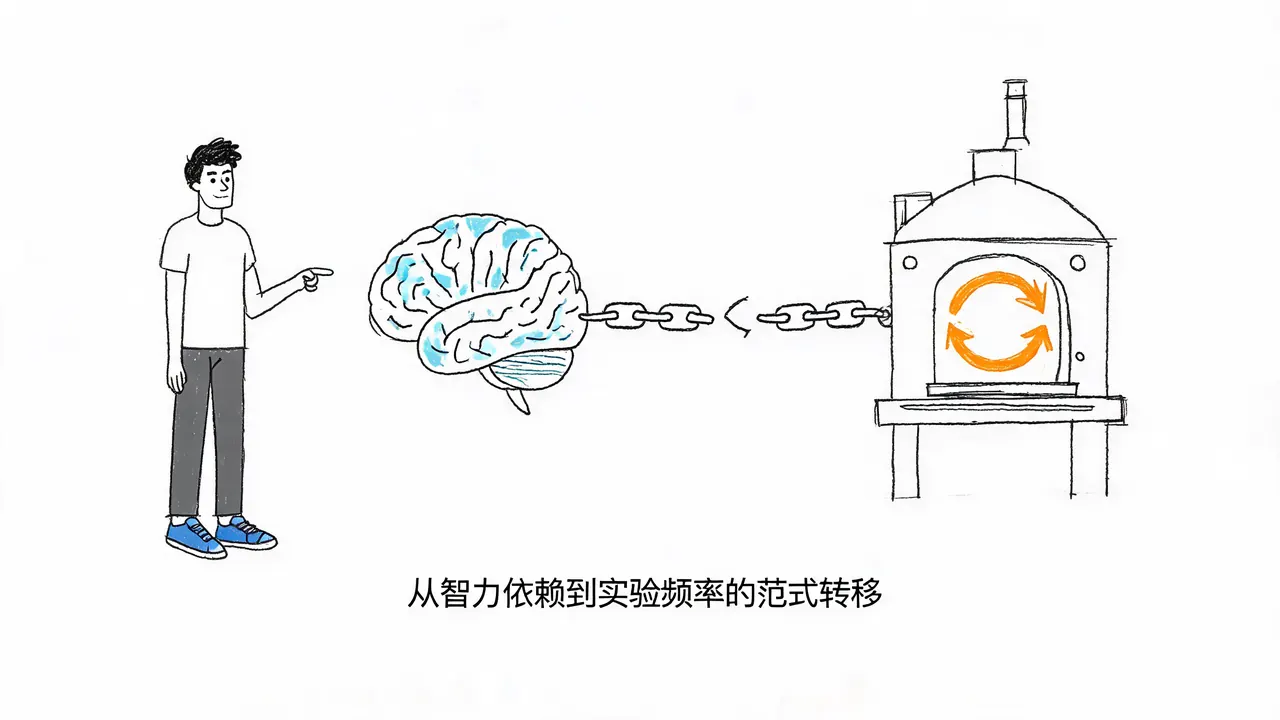
本文探讨大模型研发中“炉次”(有效实验回合数)的核心地位。分析为何智力仅是入场券,算力本质是购买实验机会,以及规模法则如何锁定竞争格局,揭示算力真正拖慢的是人才厚度而非模型分数。
解析稀疏架构如何以3%的激活参数实现高效推理,探讨算力预算、思考长度与尝试次数对模型能力的真实影响,揭示中美大模型在资源约束下的不同技术路径。
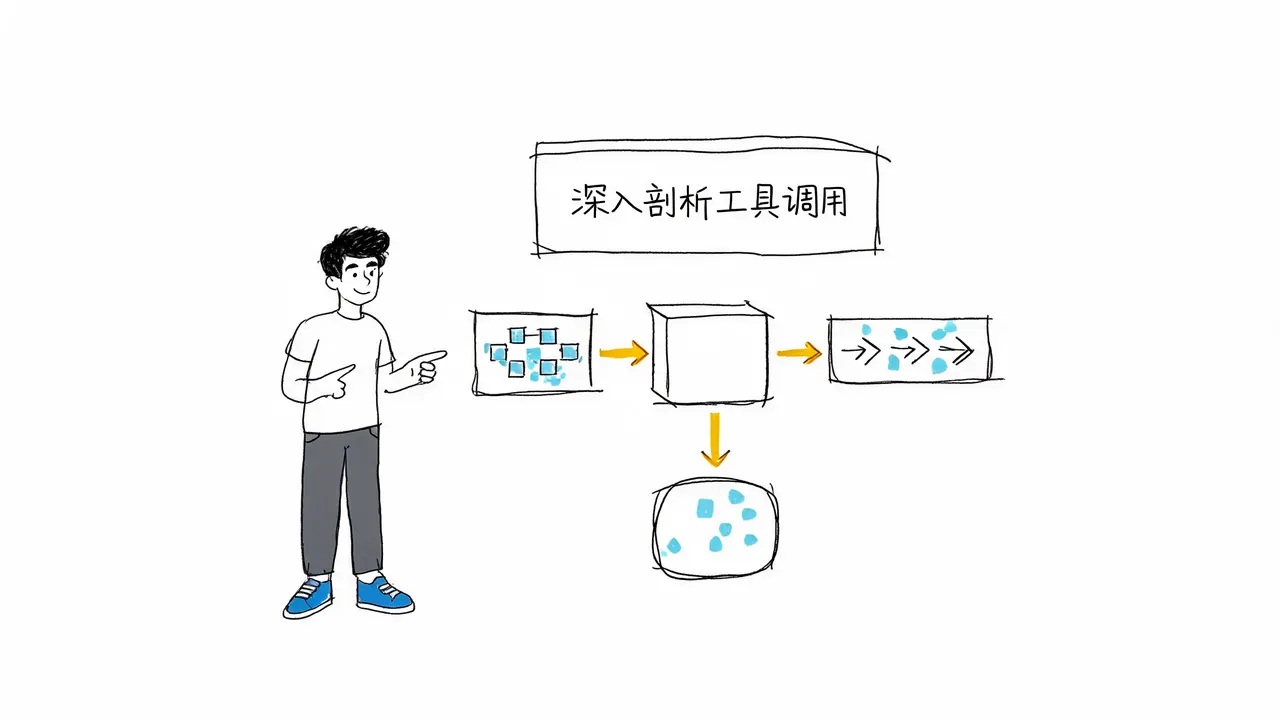
本文深入解析 Function Calling 机制,阐述大模型如何通过生成结构化请求连接外部系统。文章拆解了工具声明、六步调用闭环及安全风险边界,并总结了面试中关于模型与系统职责分工的核心观点。
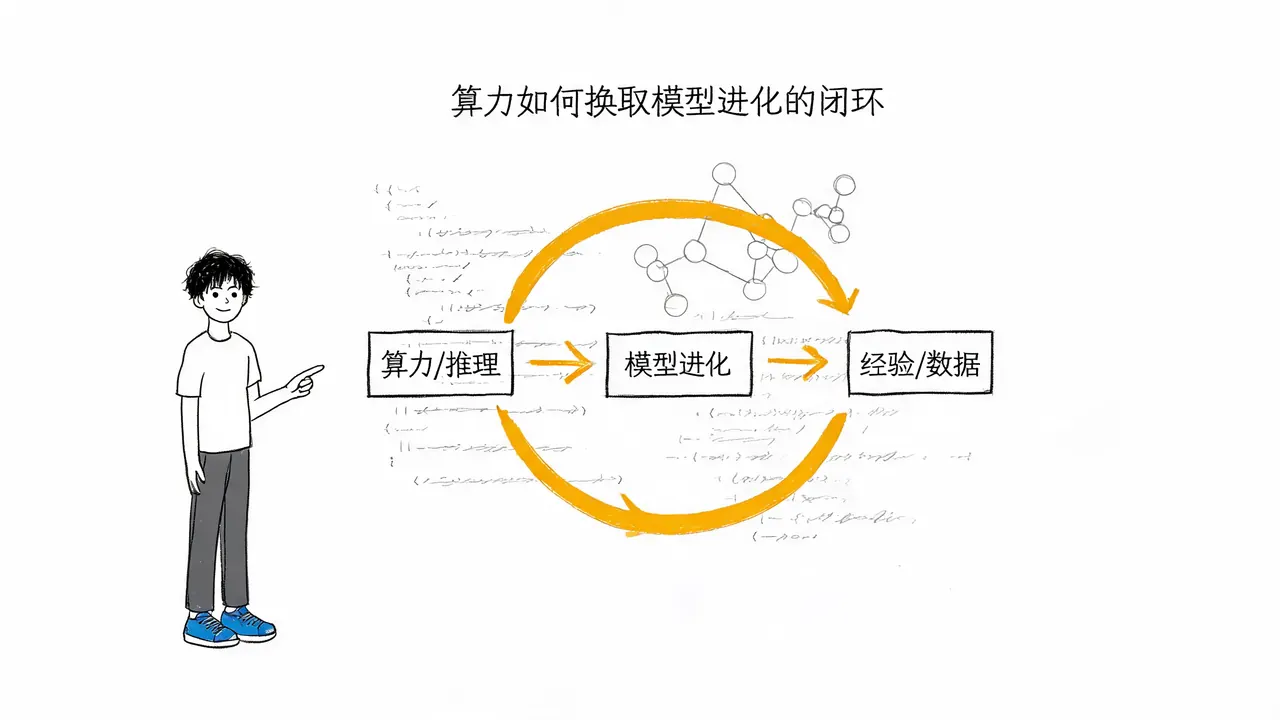
互联网文本虽多,但带结果标签的经验稀缺。合成数据需裁判机制,大规模应用产生的经验轨迹才是下一代模型的核心原料。算力从一次性训练转向持续实验,验证器边界决定自主学习上限。
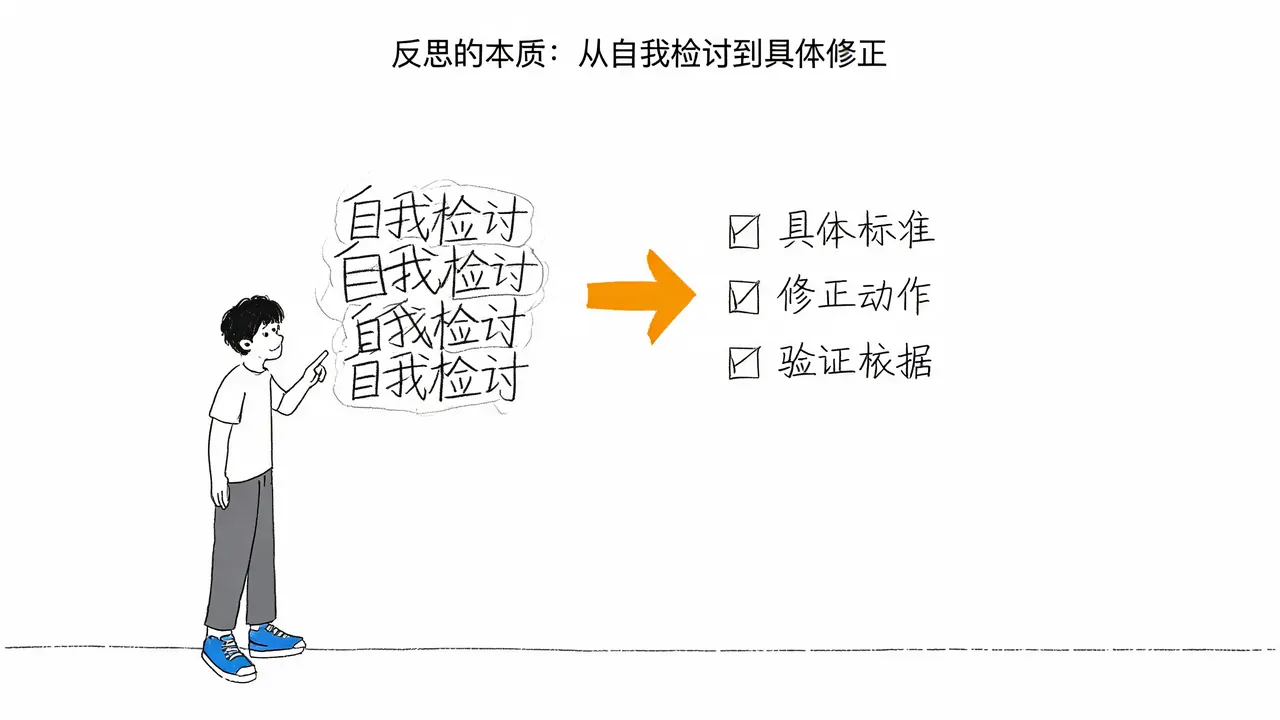
大模型常出现“诚恳道歉但答案依旧错误”的现象,这是因为缺乏外部验证的反思往往只是换种说法。本文探讨如何在系统中分离自我评价与外部验证,通过设定具体验收标准、引入客观证据及明确停止条件,构建受约束的纠错流程。
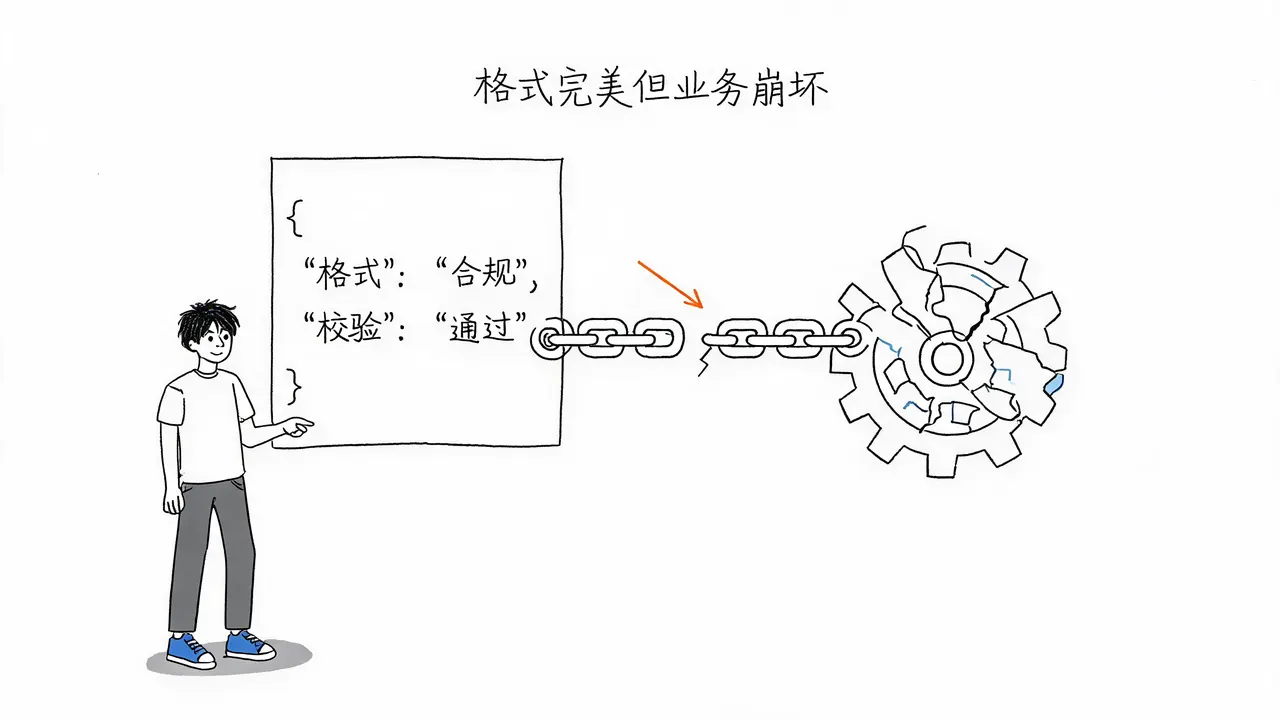
大模型返回格式完美的JSON并不意味着可以直接调用接口执行。本文解析结构化输出的本质,指出其仅解决格式问题而非业务逻辑问题,并介绍“结构化输出+后端校验+用户确认”的安全执行链路,避免AI落地中的隐蔽工程陷阱。
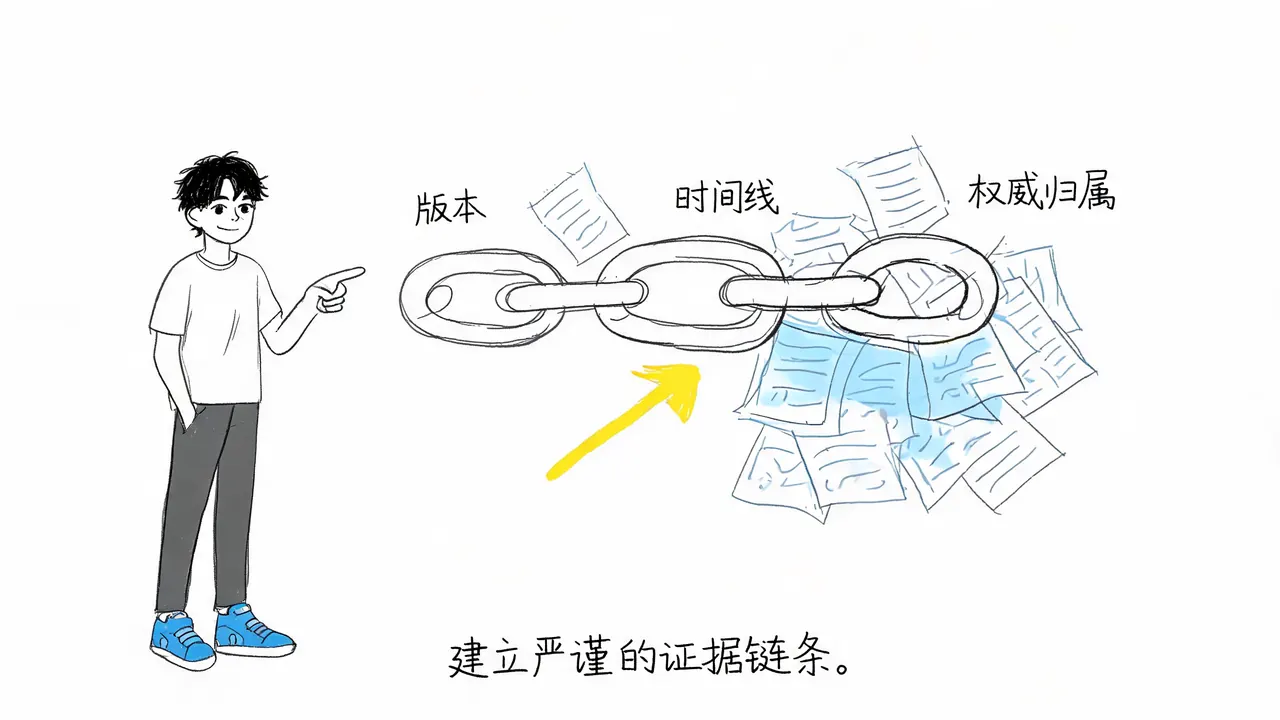
当大模型面对最新文档与过期权威手册的冲突时,往往生成“缝合怪”答案。本文从工程视角拆解检索矛盾处理链路,通过元数据优先级、意图路由及人工介入机制,构建可靠的证据链条。
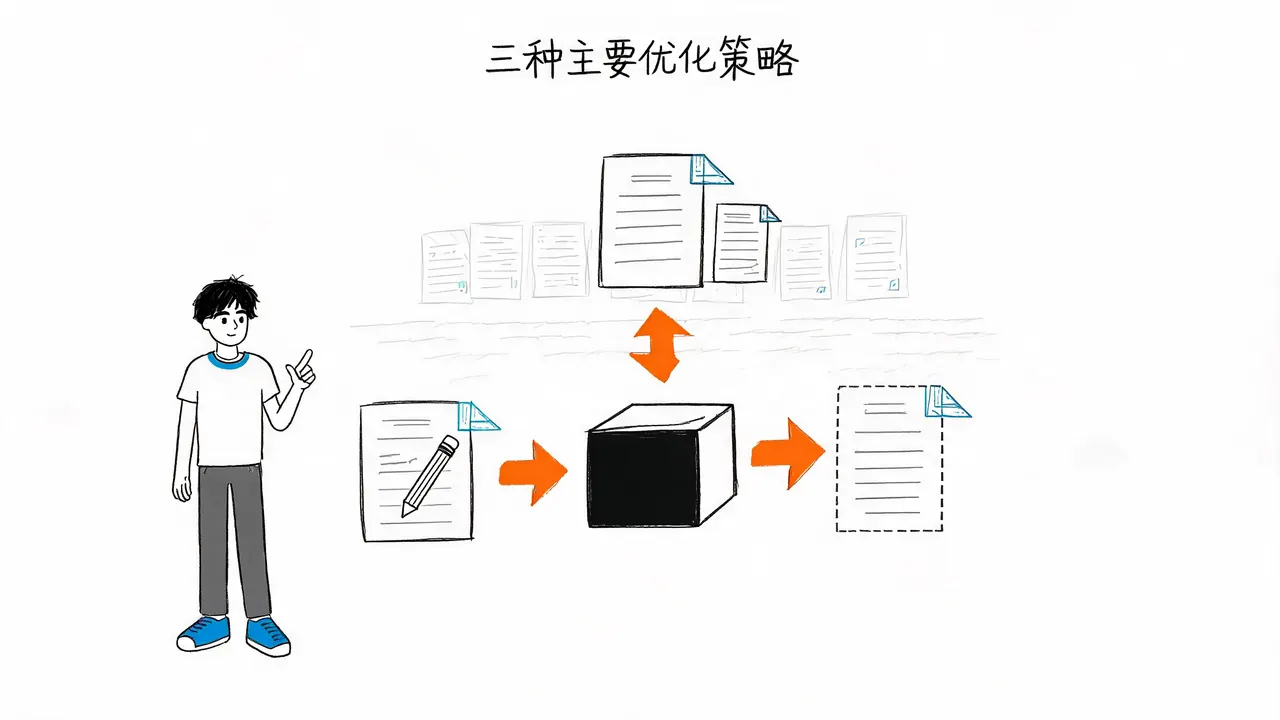
在使用大模型时遇到检索不准的问题?本文深入解析查询改写、拆分子问题和 HyDE 三种常见的检索优化策略,探讨它们各自解决的缺口、适用场景及潜在风险,帮助开发者根据实际需求选择合适的优化方案。
深入解析AI越狱(Jailbreak)的原理,探讨角色扮演、虚构场景等常见攻击手段,以及AI安全防护的局限性与最新防御技术。