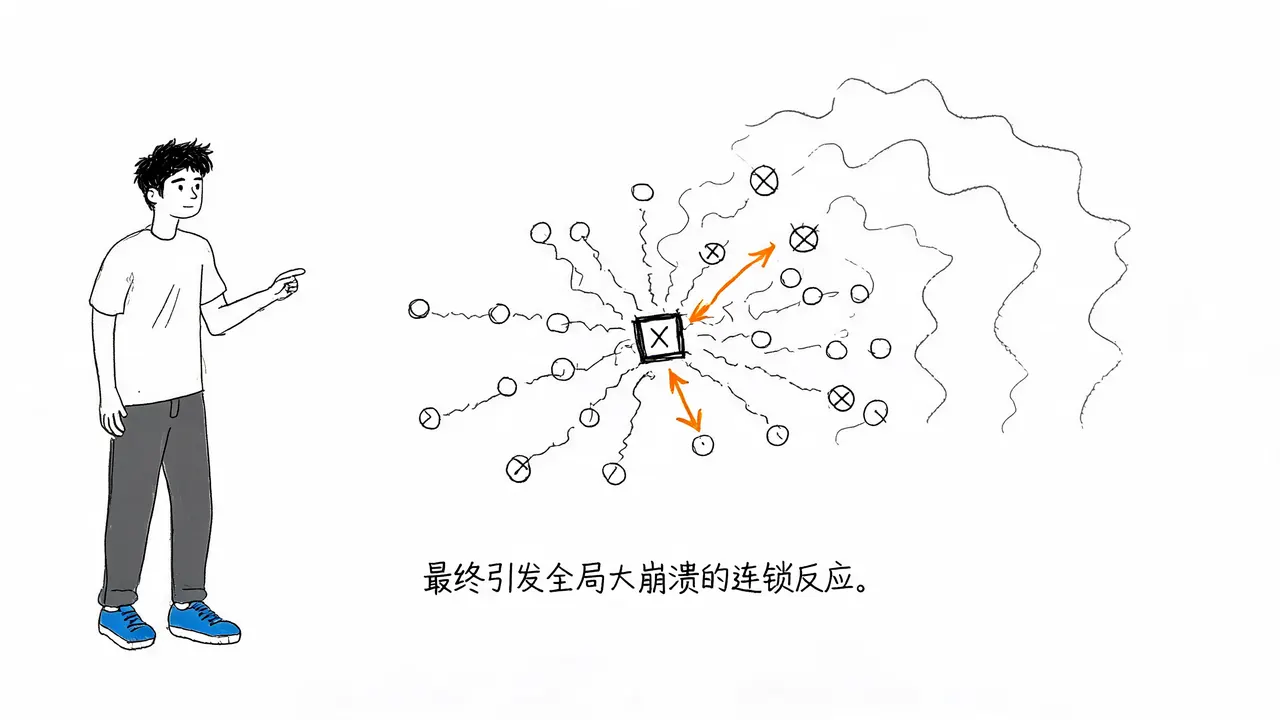
什么是雪崩效应?一个小服务怎么拖垮整个系统?
解析雪崩效应如何由局部小故障引发全局崩溃。探讨资源耗尽、重试风暴与级联故障的机制,以及熔断与降级策略在保护系统稳定性中的关键作用。
共 8 篇文章
解析雪崩效应如何由局部小故障引发全局崩溃。探讨资源耗尽、重试风暴与级联故障的机制,以及熔断与降级策略在保护系统稳定性中的关键作用。
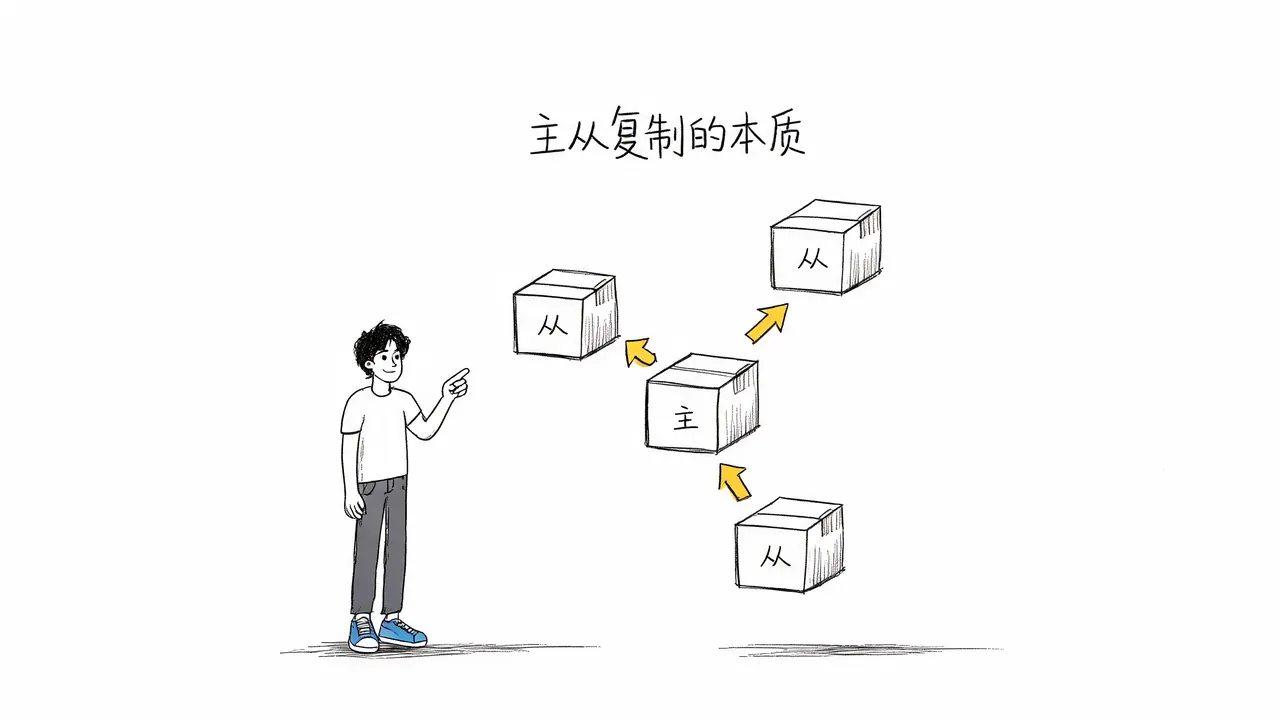
探讨Redis单机性能虽强却仍需主从复制的原因,分析单点故障与性能瓶颈,详解读写分离机制、全量与增量同步原理,以及主从复制在写并发和故障转移上的局限性。
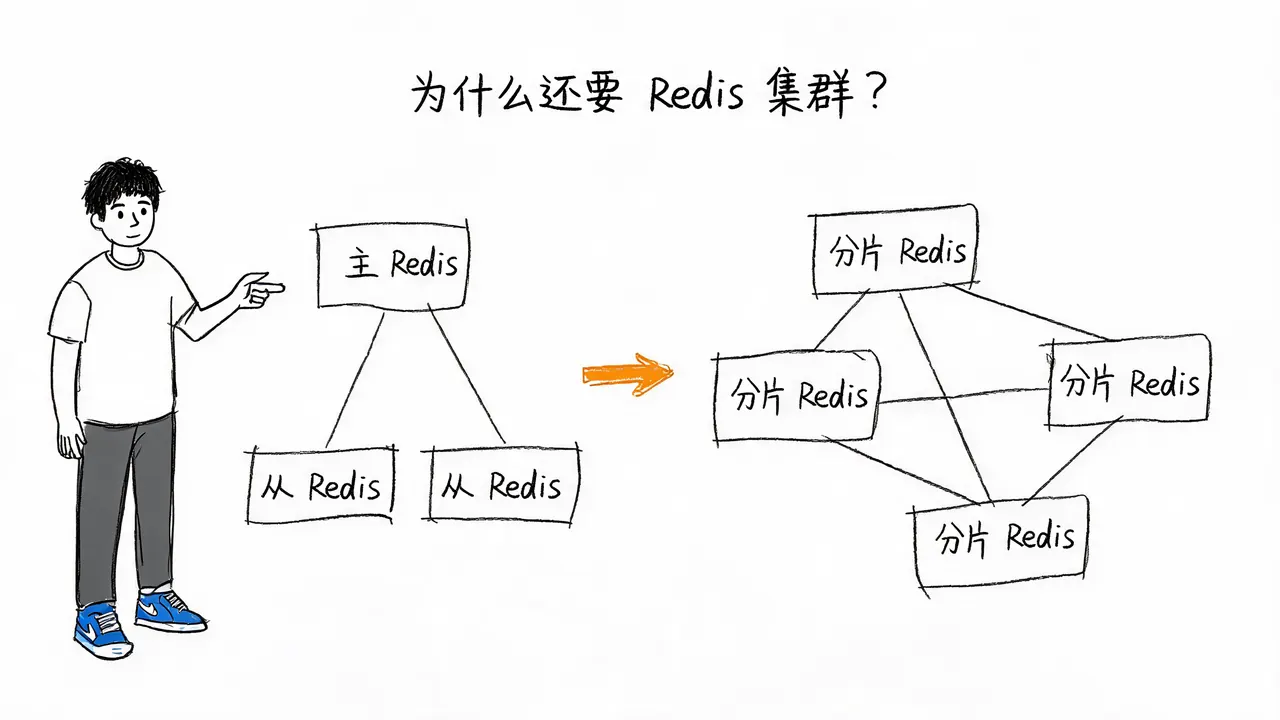
深入解析 Redis 主从复制与 Redis 集群的区别。主从复制解决数据冗余与读并发,但受限于单机内存与写性能;Redis 集群通过数据分片打破物理极限,实现水平扩展。
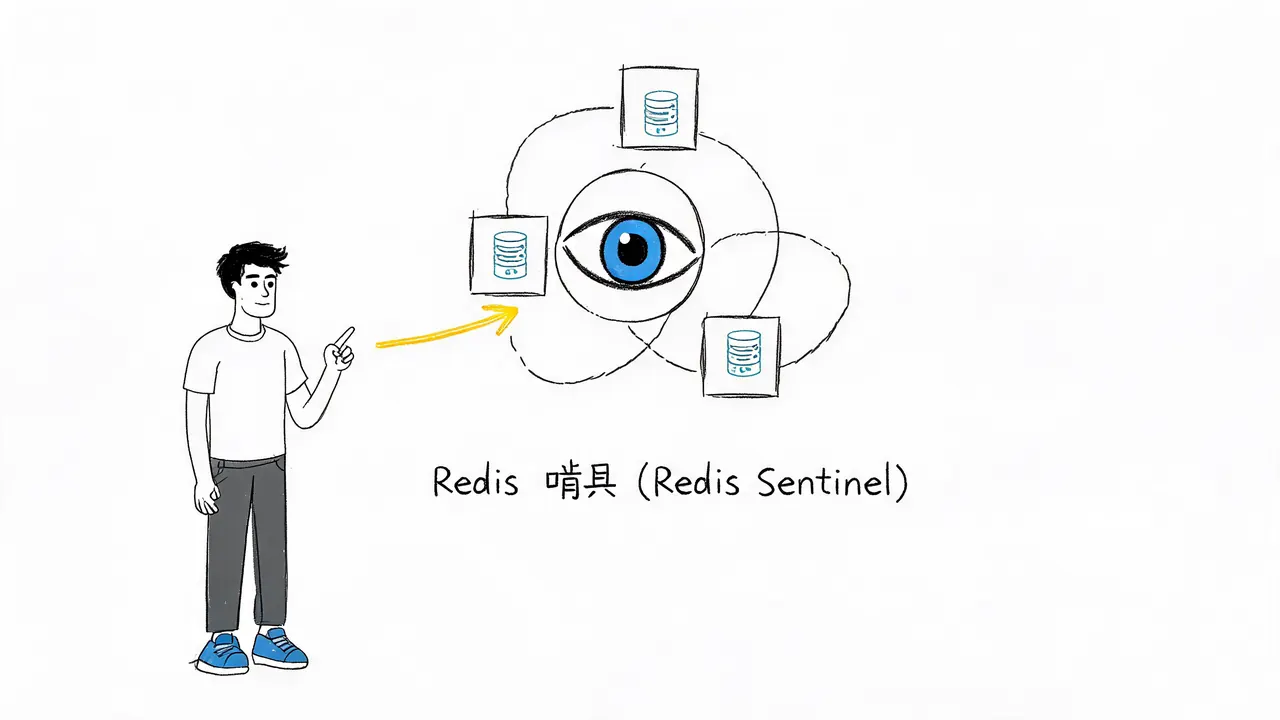
深入解析Redis哨兵模式的工作原理,包括主观与客观下线判断、Leader选举机制以及基于四层漏斗的新主节点筛选策略,揭示如何实现秒级自动故障恢复。
深入解析 Redis 哨兵机制的工作原理,包括心跳检测、主观与客观下线判断、自动故障转移流程,以及其在数据分片和脑裂场景下的能力边界。
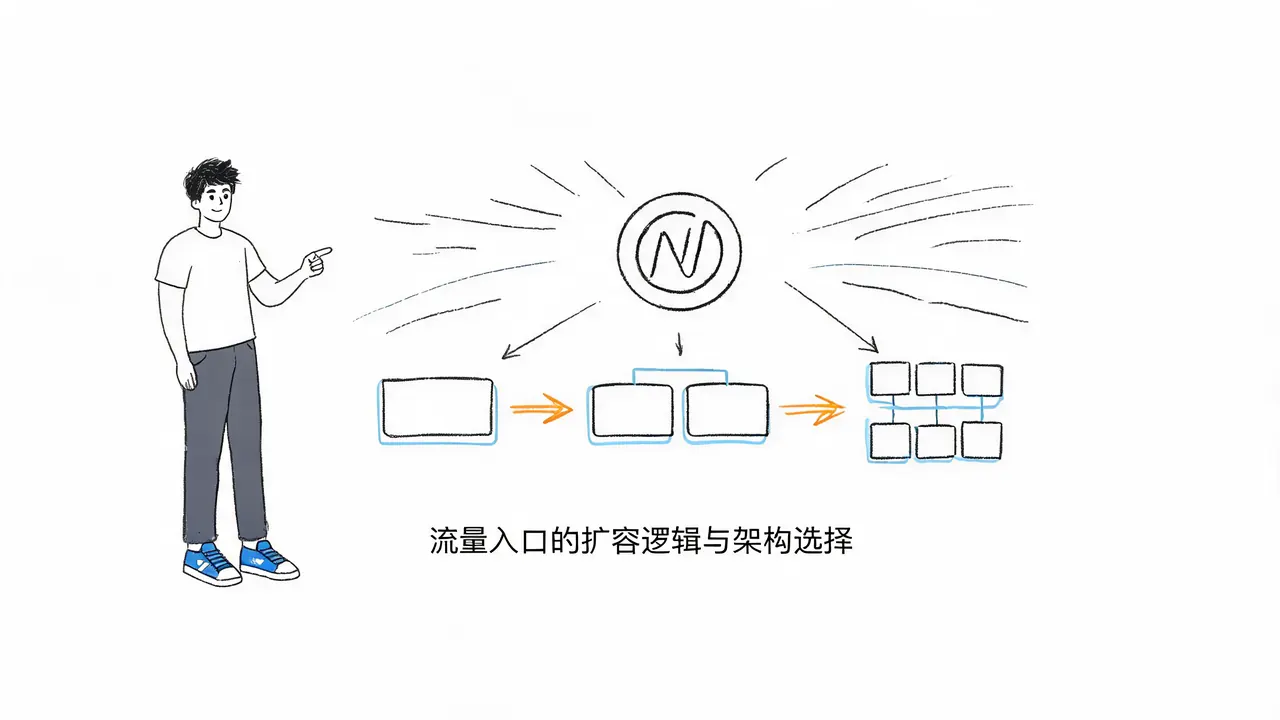
解析Nginx单机的物理边界与瓶颈,探讨从主备高可用到LVS集群的演进路径,并指出避免过度设计的架构原则。
单机Kafka虽具备百万级吞吐量,但在面对海量数据存储、单点故障风险及高并发读写时存在物理极限。本文深入解析Kafka集群如何通过分区、副本机制及水平扩展打破单机瓶颈,实现高可用与高性能。
深入解析Redis脑裂现象:从网络隔离到哨兵误判,揭示双主共存导致数据丢失的根本原因,并探讨最小从节点写入限制等防御机制。