分布式定时任务可靠性设计:从脑裂防护到故障转移的完整方案
本文深入解析分布式定时任务在集群脑裂、节点宕机、任务重叠及积压等场景下的可靠性设计。通过调度层仲裁、执行层幂等、超时检测及分级隔离策略,构建生产级的高可用定时任务体系,帮助后端工程师应对复杂生产环境挑战。
共 428 篇文章
本文深入解析分布式定时任务在集群脑裂、节点宕机、任务重叠及积压等场景下的可靠性设计。通过调度层仲裁、执行层幂等、超时检测及分级隔离策略,构建生产级的高可用定时任务体系,帮助后端工程师应对复杂生产环境挑战。
本文提供了一套完整的基金筛选六步法,从自我认知、方向选择、指数对比、基本面体检、费率比较到仓位管理与定期复盘,帮助投资者建立独立判断能力,摆脱盲目跟风,通过提升认知和保持耐心实现长期稳健收益。
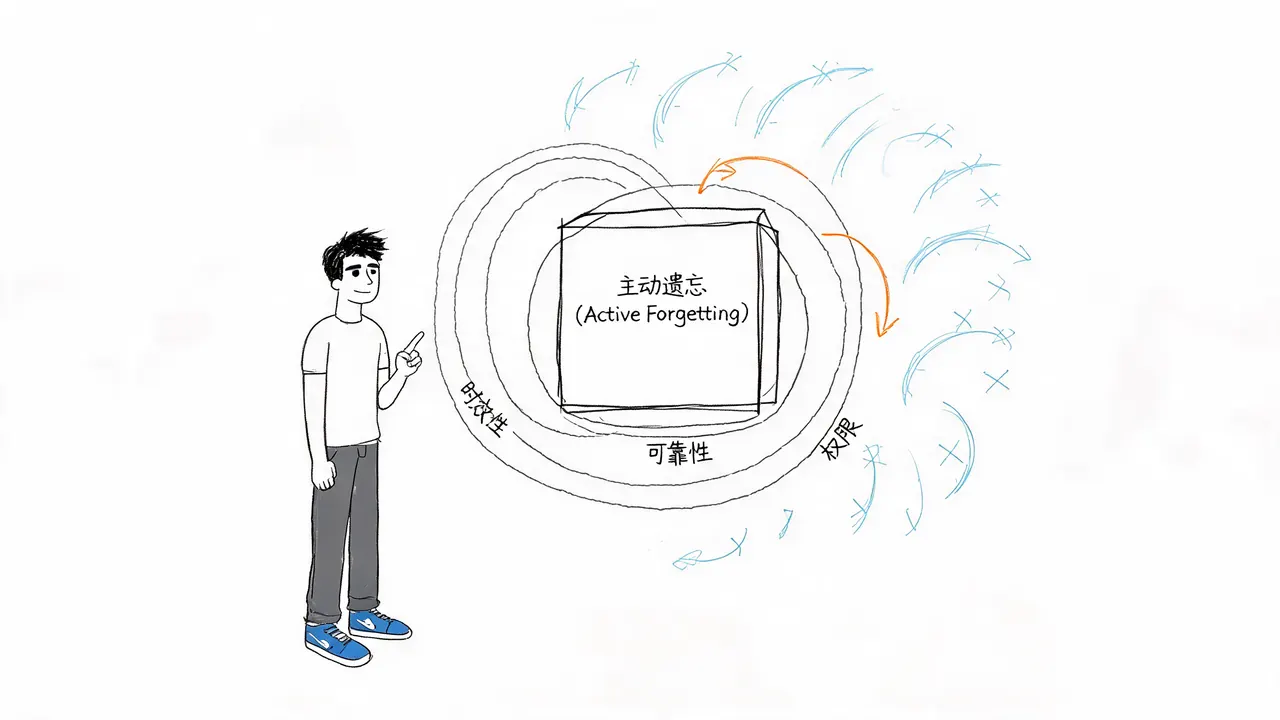
在 AI 智能体应用中,直接调用最相似的历史记忆并不总是正确的。旧方案可能已过期或权限变更,盲目复用会导致错误结果。本文探讨智能体记忆系统中“主动遗忘”的必要性,包括记忆失效、降权策略及合规审计的处理方法,旨在构建精准、高效且安全的记忆检索机制。
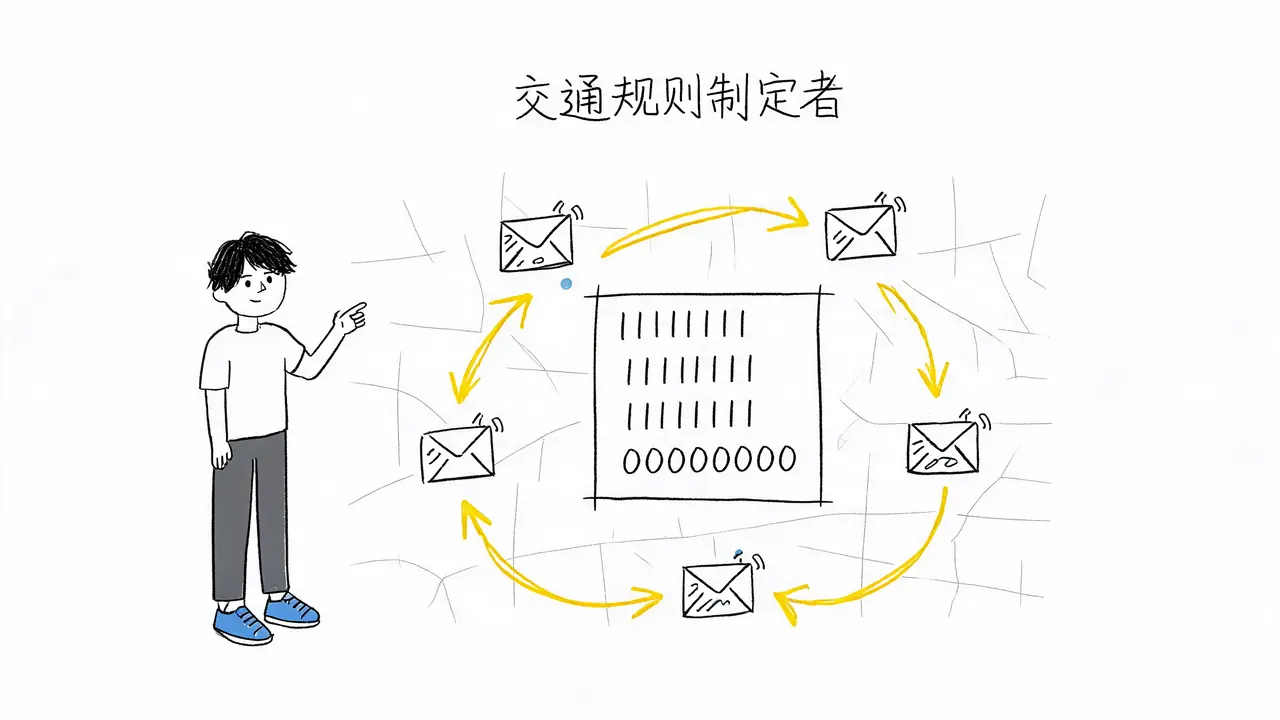
子网掩码是区分IP地址中网络部分与主机部分的关键参数。本文深入解析其32位二进制结构、逻辑与运算原理、子网划分作用及CIDR表示法,帮助理解数据包路由决策机制。
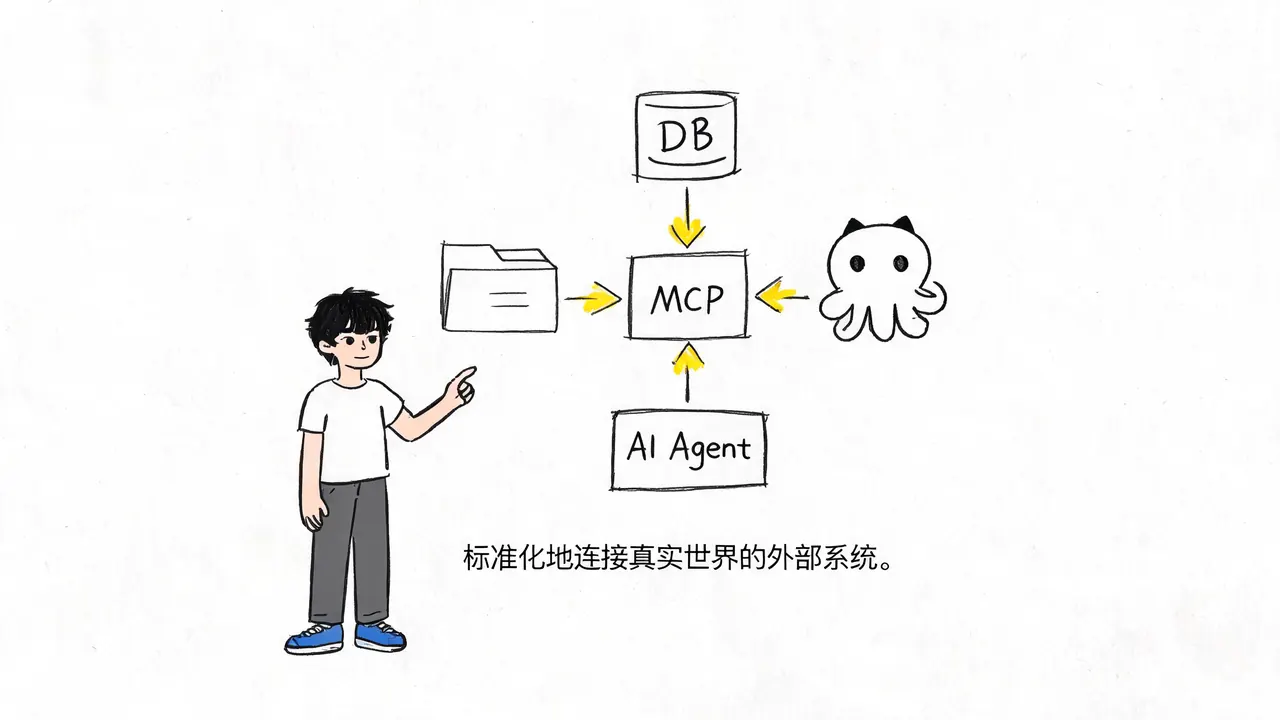
本文深入解析 MCP(Model Context Protocol)协议,阐述其如何通过 Host、Client、Server 三层架构解决 AI Agent 连接外部系统的碎片化问题,并明确其作为连接层而非安全或业务闭环层的边界。
深入解析数据库连接池耗尽的排查思路与连接泄漏的兜底方案。从连接池方案对比、风险量化分析到架构落地规范,帮助后端工程师构建高可用的数据库资源防护体系,避免全链路雪崩。
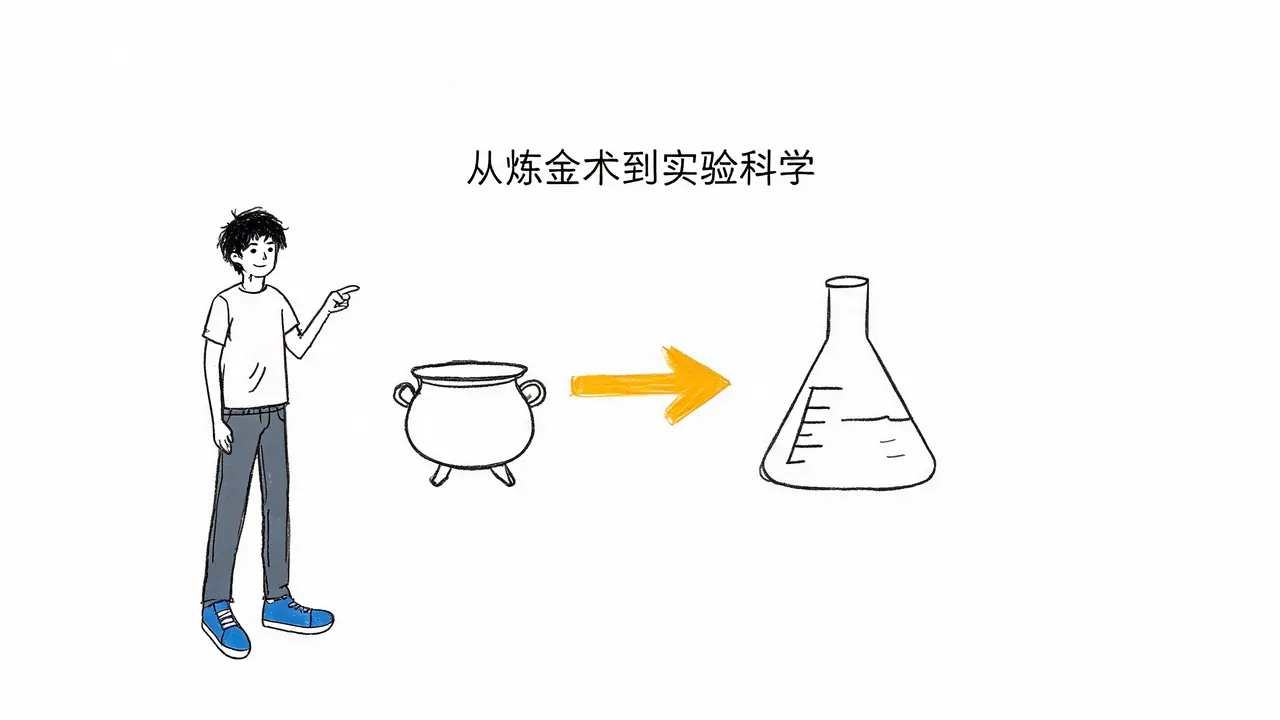
传统软件依赖代码断言与证明,而大模型的能力无法被推导,只能被测量。本文通过对比蒸汽机与热力学、化学与数学,揭示大模型研发本质上是实验科学,其核心壁垒在于团队积累的“手感经验”而非单一理论突破。
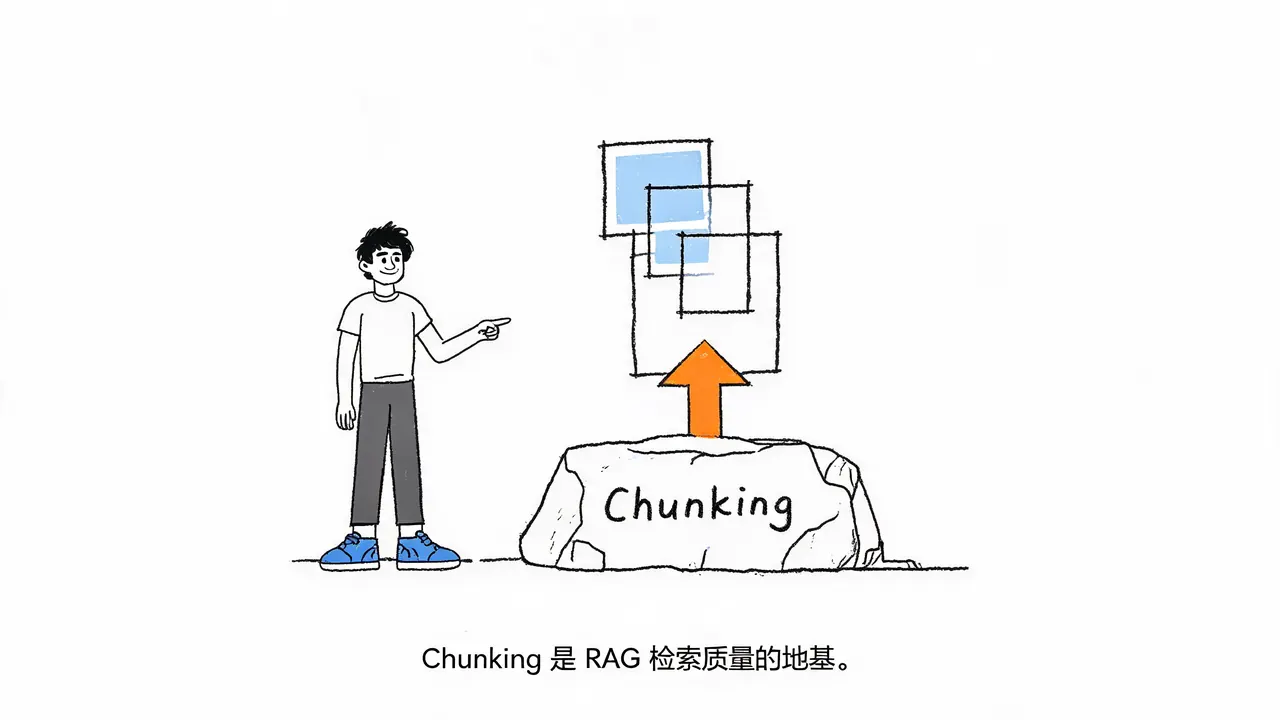
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
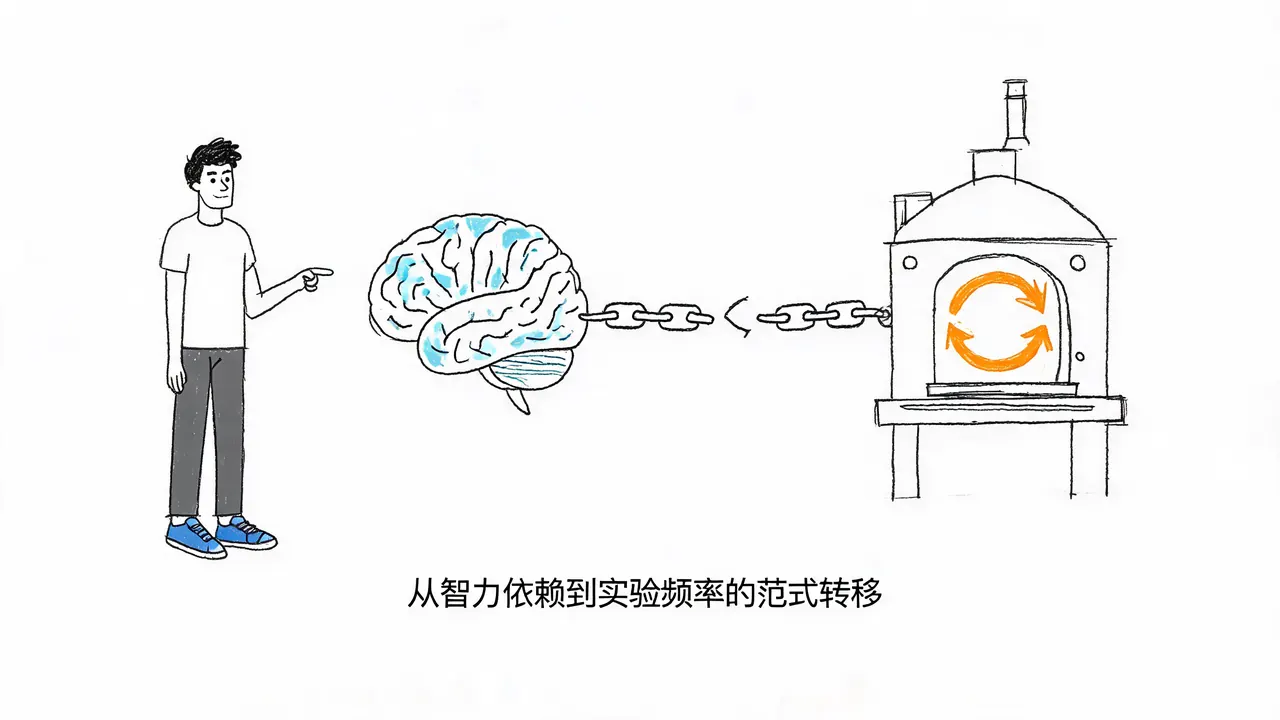
本文探讨大模型研发中“炉次”(有效实验回合数)的核心地位。分析为何智力仅是入场券,算力本质是购买实验机会,以及规模法则如何锁定竞争格局,揭示算力真正拖慢的是人才厚度而非模型分数。
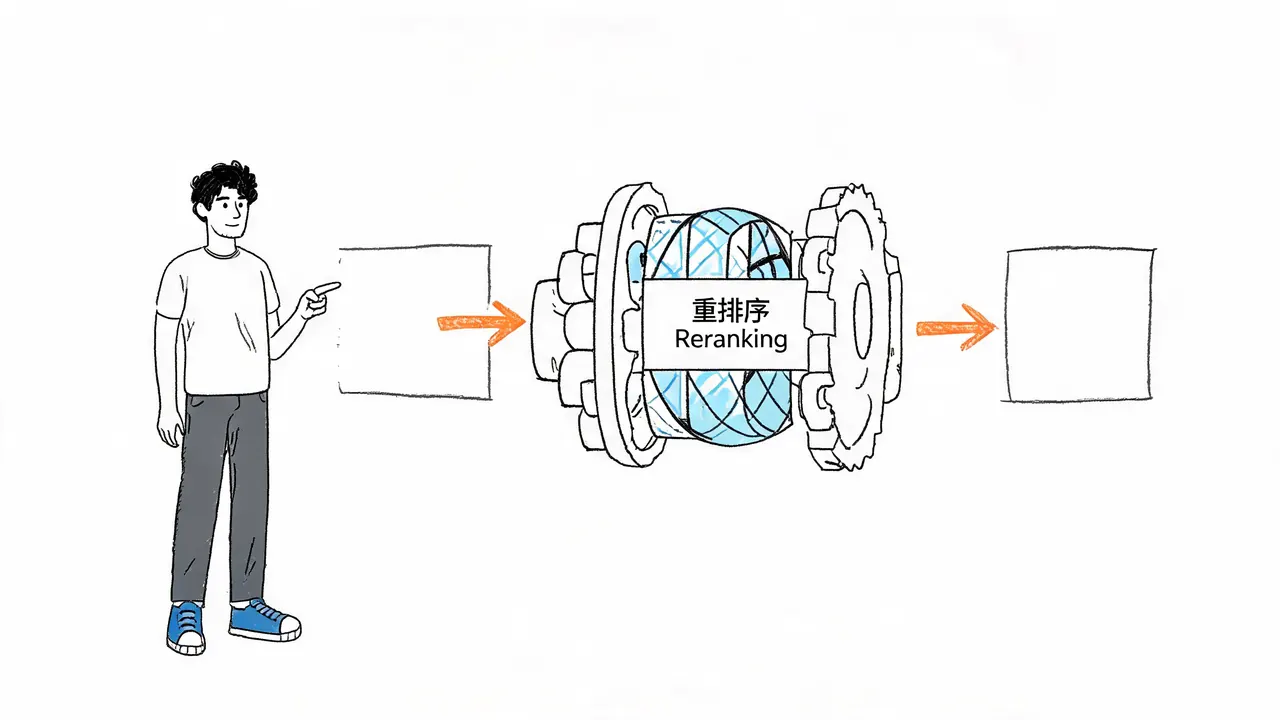
在 RAG 系统中,检索成功但答案不准往往源于重排序环节。本文解析重排序在召回与生成之间的关键位置,对比向量与关键词检索的盲区,阐述交叉编码器原理,并明确其受限于召回率、切分质量及算力成本的三大边界。
中美AI模型公开评测分数差距不足3%,但算力总预算差距显著。本文解析总算力、高端芯片及新增份额的多维差距,探讨算力约束如何影响训练与推理的资源取舍、技术路线探索半径,以及最终对人才成长速度和实验席位的长期影响。
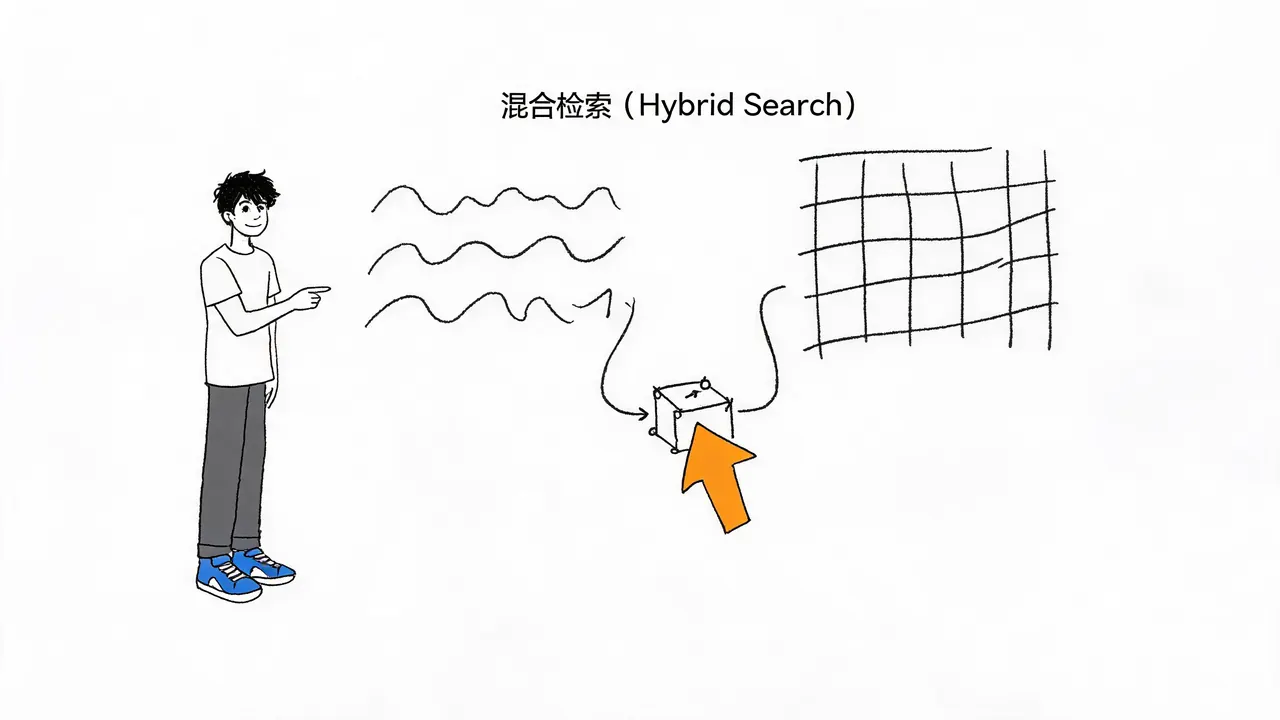
深入解析混合检索(Hybrid Search)的核心原理,探讨如何通过向量检索与关键词检索的双路召回及融合排序,解决单一检索方式在语义理解和精确匹配上的局限性,提升 RAG 系统的召回鲁棒性。