模型上线就变笨?带你搞懂 Harness Engineering 与工程外壳
为什么 AI 模型在测试环境表现优异,上线后却频繁出错?本文深入解析 Harness Engineering(工程外壳)的概念,揭示上下文装配、工具管理及错误处理对 Agent 表现的关键影响,并提供基于运行链路的系统性排查策略。
共 428 篇文章
为什么 AI 模型在测试环境表现优异,上线后却频繁出错?本文深入解析 Harness Engineering(工程外壳)的概念,揭示上下文装配、工具管理及错误处理对 Agent 表现的关键影响,并提供基于运行链路的系统性排查策略。
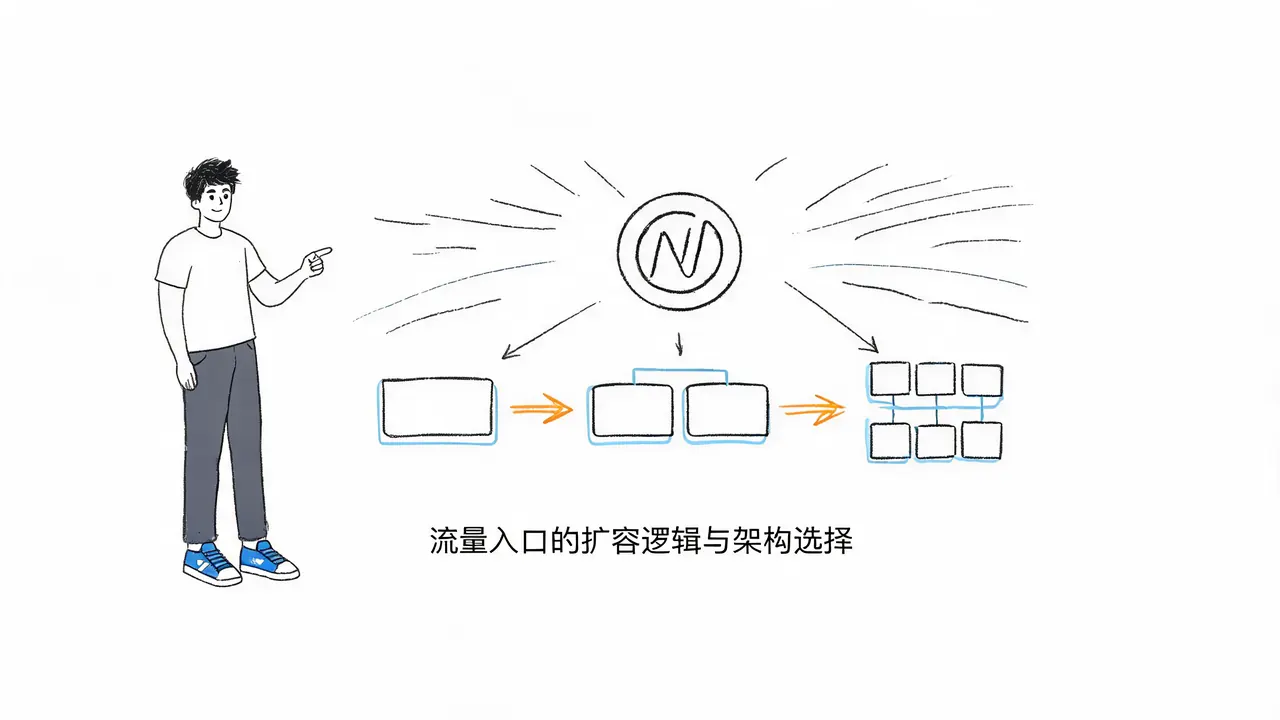
解析Nginx单机的物理边界与瓶颈,探讨从主备高可用到LVS集群的演进路径,并指出避免过度设计的架构原则。
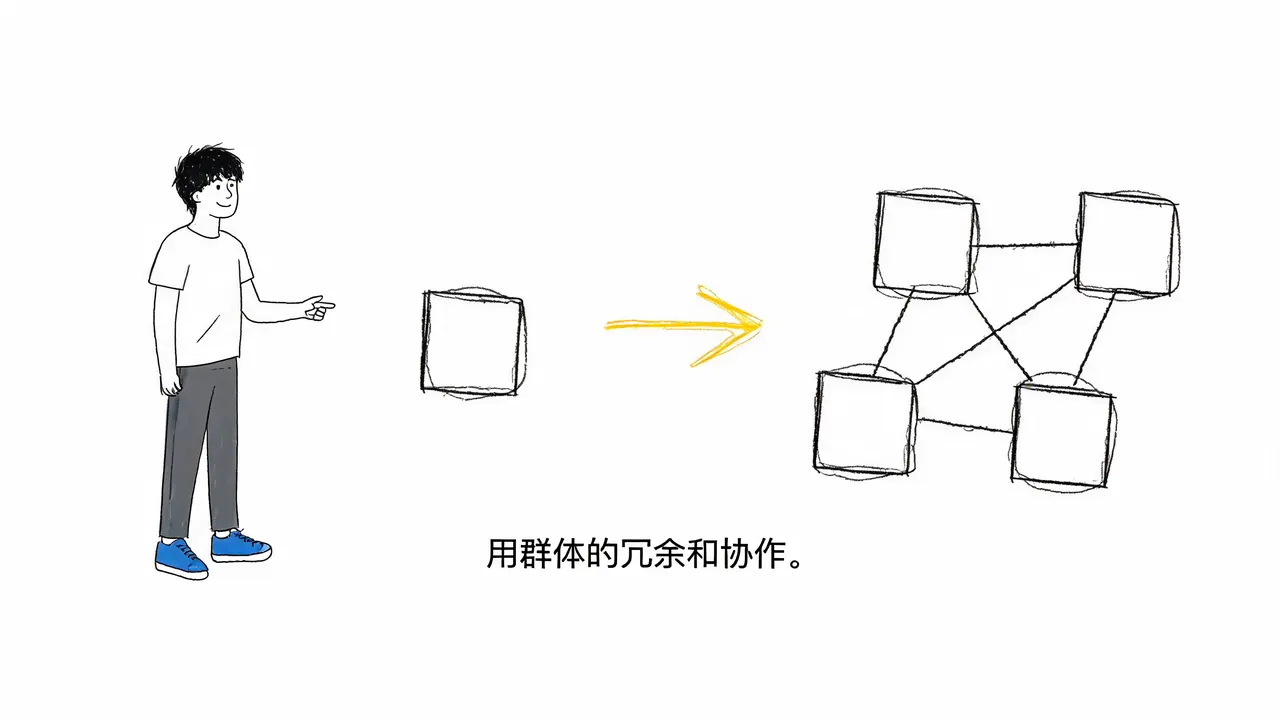
单机Kafka虽具备百万级吞吐量,但在面对海量数据存储、单点故障风险及高并发读写时存在物理极限。本文深入解析Kafka集群如何通过分区、副本机制及水平扩展打破单机瓶颈,实现高可用与高性能。
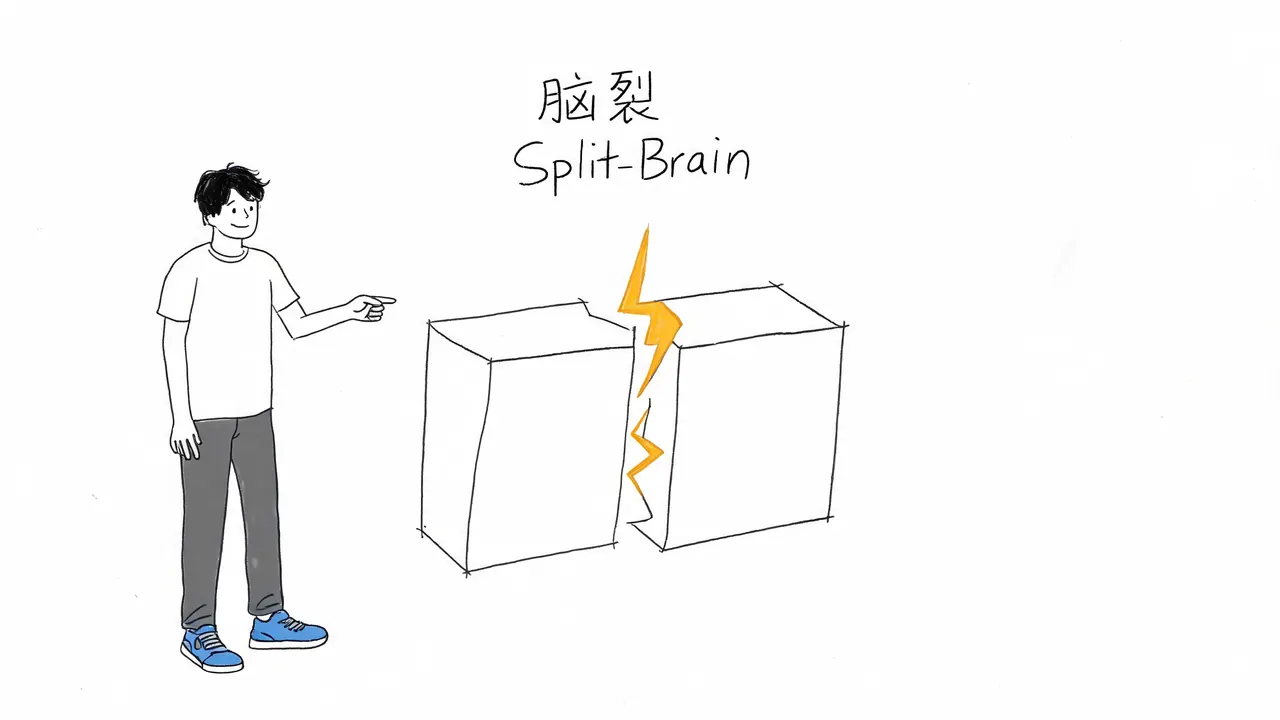
深入解析Redis脑裂现象:从网络隔离到哨兵误判,揭示双主共存导致数据丢失的根本原因,并探讨最小从节点写入限制等防御机制。
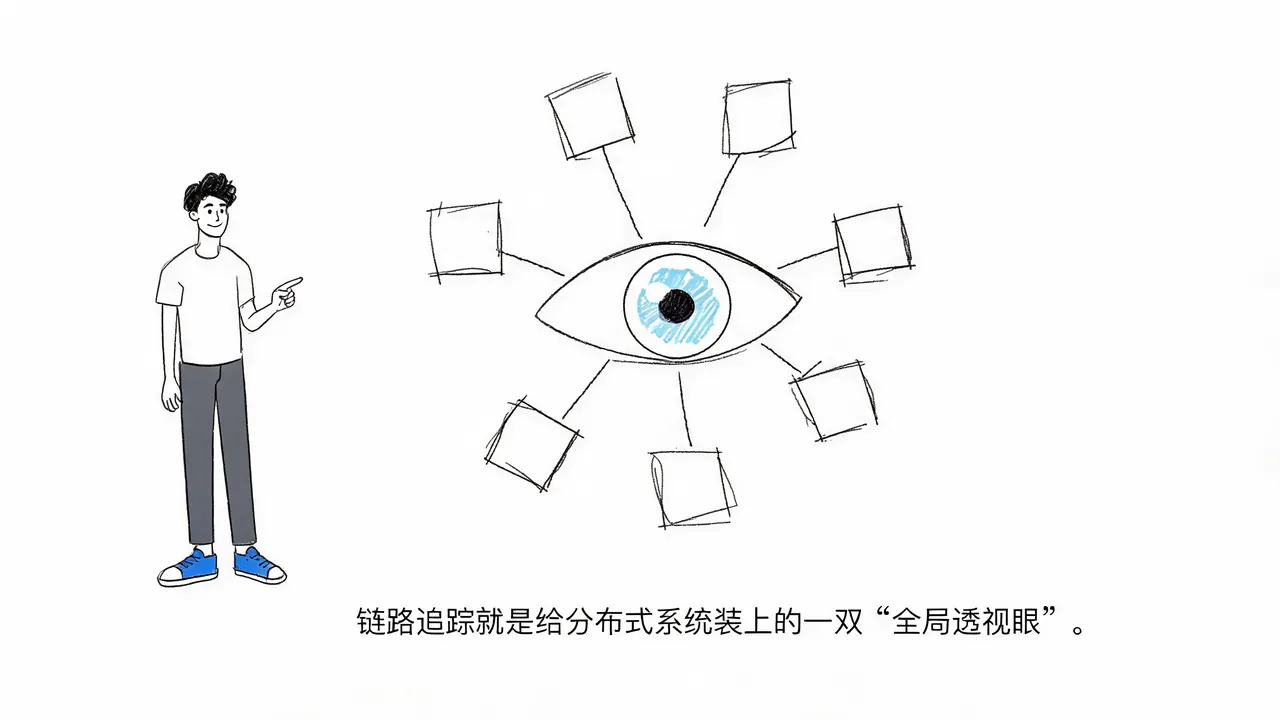
当系统拆分为大量微服务后,传统局部日志排障彻底失效。本文深入解析链路追踪的核心机制(TraceID与Span),阐述其如何解决故障定位难、性能瓶颈隐蔽等问题,并探讨适用场景与性能权衡。
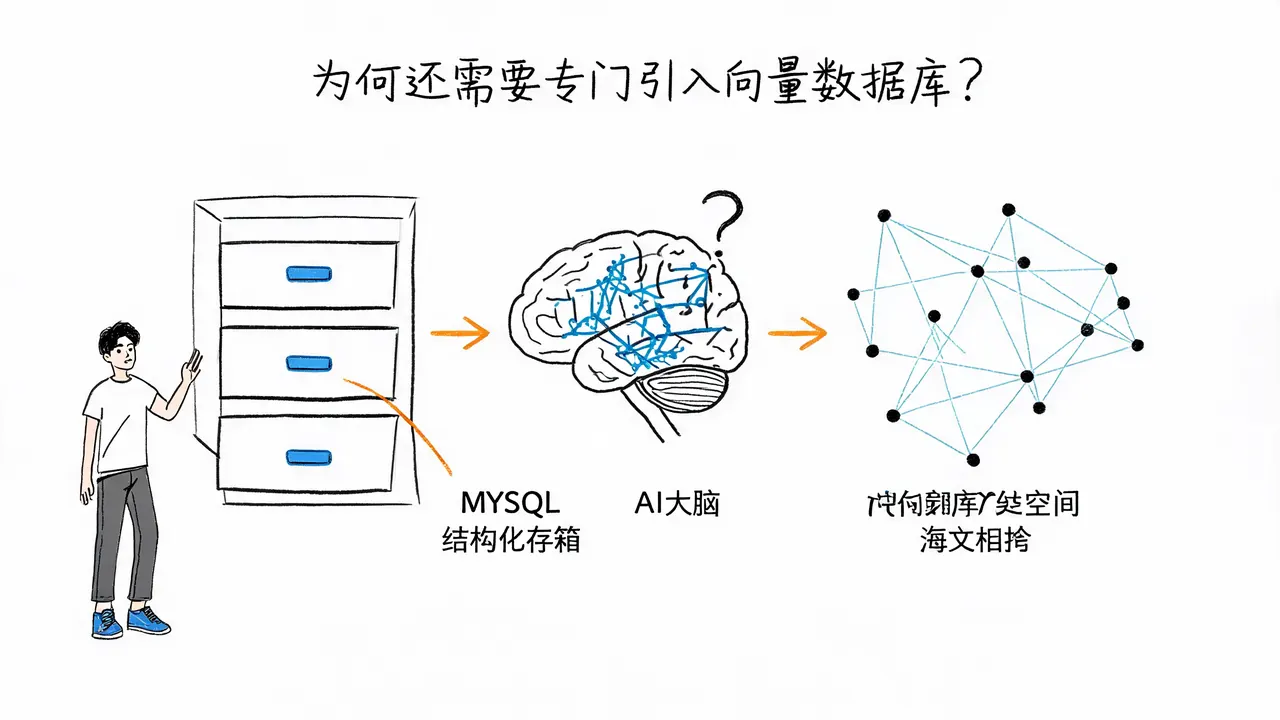
深入解析MySQL与向量数据库的核心差异。MySQL擅长结构化数据的精确查询,而向量数据库通过Embedding和ANN算法,专为AI时代的语义检索和非结构化数据处理而生。了解两者如何分工协作,构建现代AI应用的数据底座。
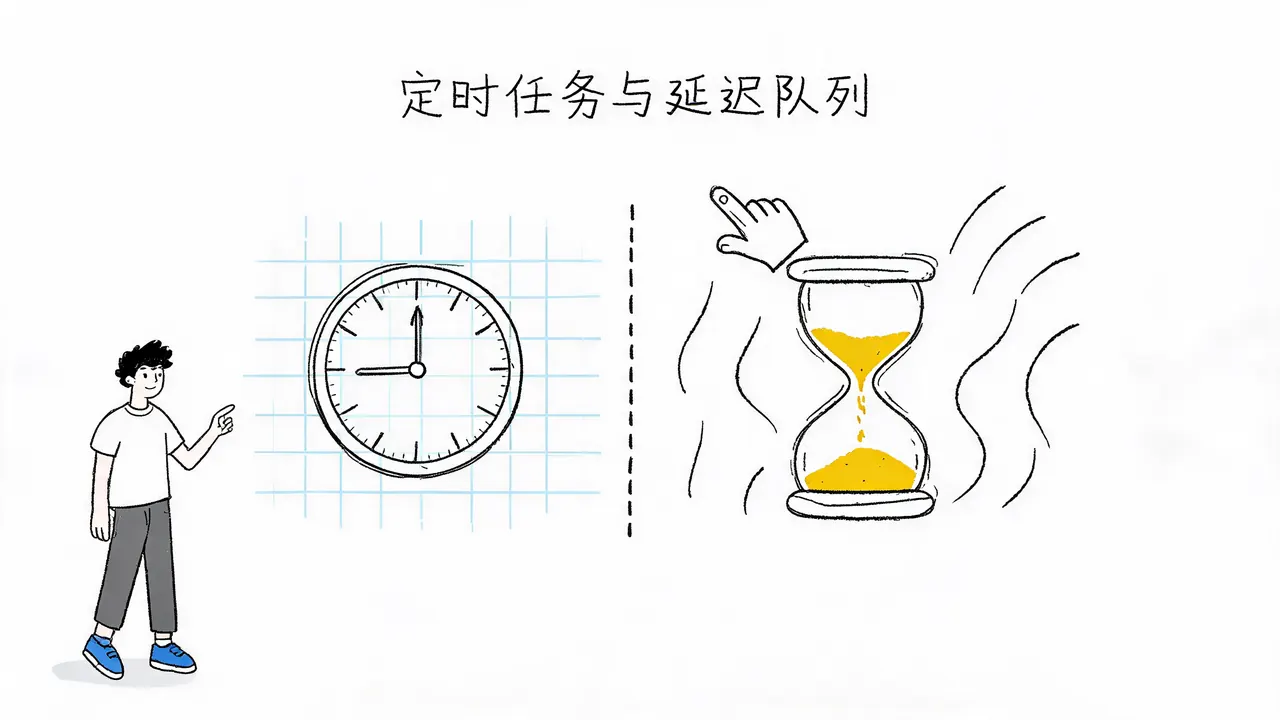
深入解析定时任务与延迟队列的本质区别。通过对比触发机制、执行周期及性能影响,明确两者在订单超时、数据备份等场景下的最佳实践,帮助开发者避开性能坑,选对工具。
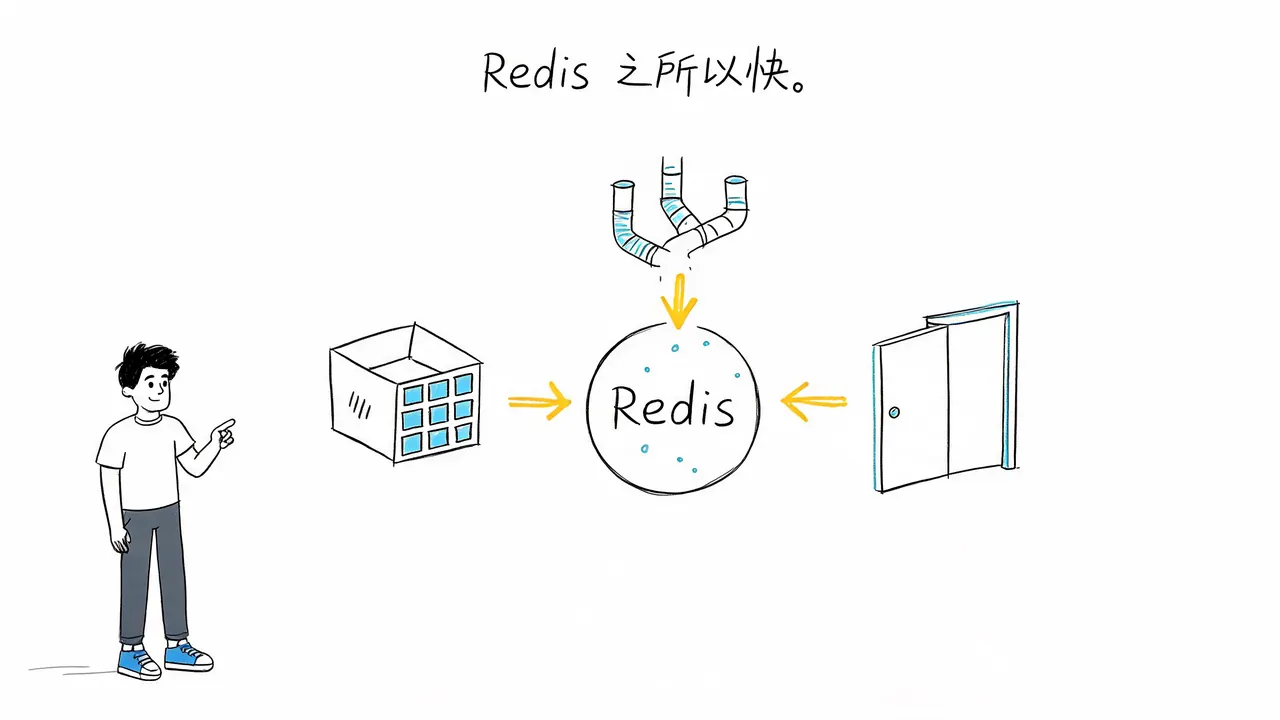
深入解析Redis单线程模型的高性能原理。探讨其如何通过避免锁竞争、利用IO多路复用及内存操作,在特定场景下实现超高吞吐量,并分析其潜在风险与适用边界。
深入解析慢 SQL 如何通过耗尽连接池、榨干 CPU 与磁盘资源、引发锁竞争三大机制拖垮数据库。理解其破坏原理,掌握预防雪崩的关键策略。
深入解析 Sentinel 在微服务架构中的核心作用,厘清限流与熔断的区别与分工,探讨如何防止雪崩效应,保障系统在高并发场景下的稳定性。
解析 Next.js 如何通过 Router Handlers 和 Server Components 打破前后端边界,探讨其适用场景及与传统后端的分工差异。
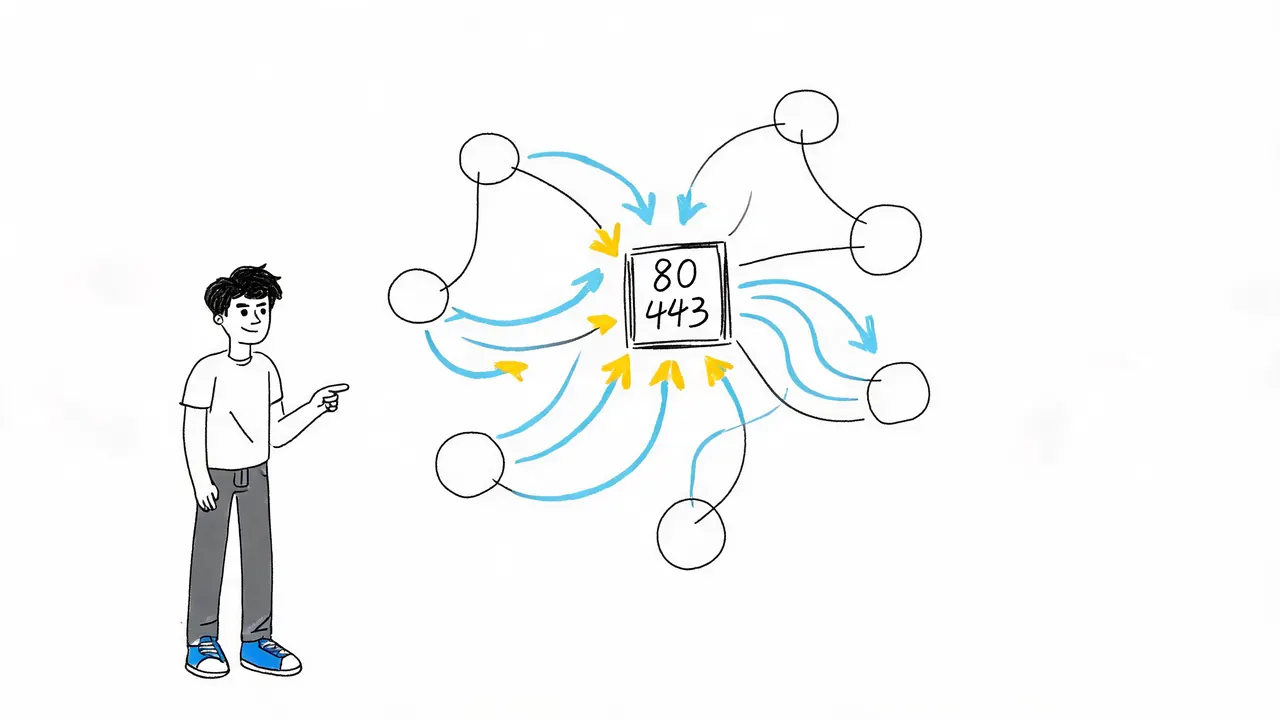
深入解析网络端口的本质:它并非物理插孔,而是操作系统用于区分不同程序通信通道的逻辑标识。通过快递类比,详解端口分类、工作机制及在网络安全中的关键作用。