稀疏架构与算力预算:为何模型参数规模不等于推理能力
解析稀疏架构如何以3%的激活参数实现高效推理,探讨算力预算、思考长度与尝试次数对模型能力的真实影响,揭示中美大模型在资源约束下的不同技术路径。
共 428 篇文章
解析稀疏架构如何以3%的激活参数实现高效推理,探讨算力预算、思考长度与尝试次数对模型能力的真实影响,揭示中美大模型在资源约束下的不同技术路径。
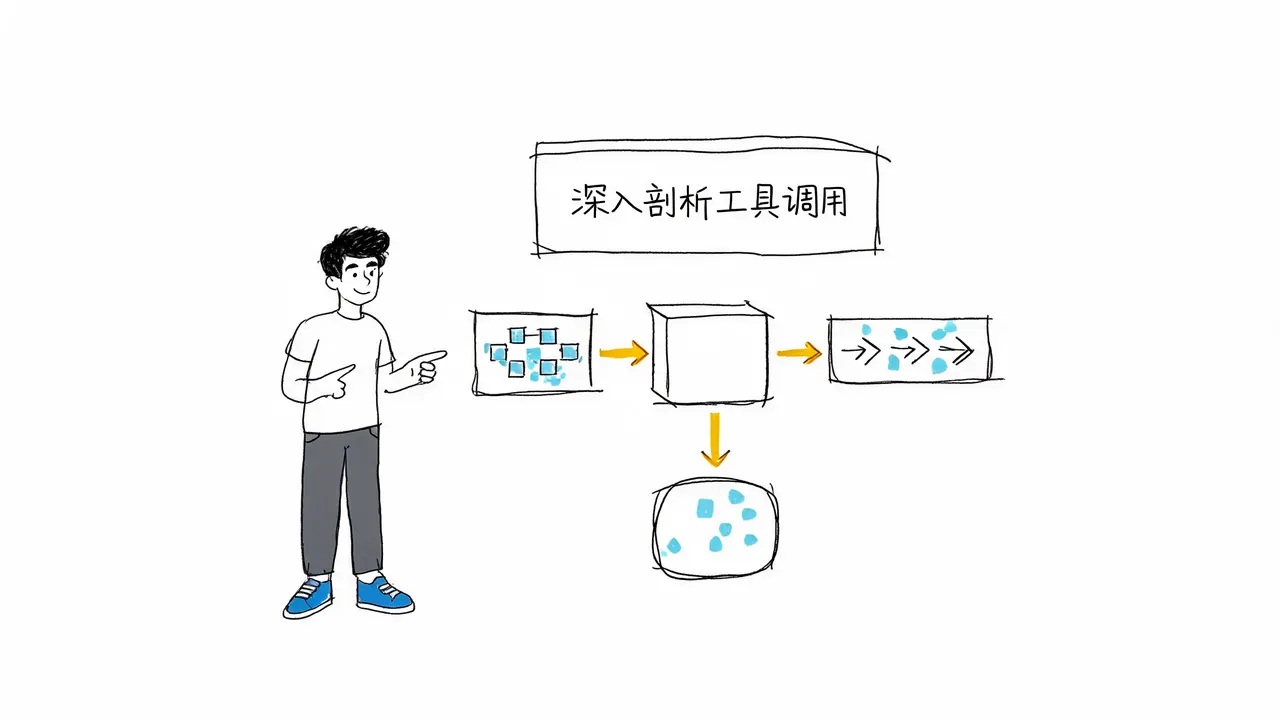
本文深入解析 Function Calling 机制,阐述大模型如何通过生成结构化请求连接外部系统。文章拆解了工具声明、六步调用闭环及安全风险边界,并总结了面试中关于模型与系统职责分工的核心观点。
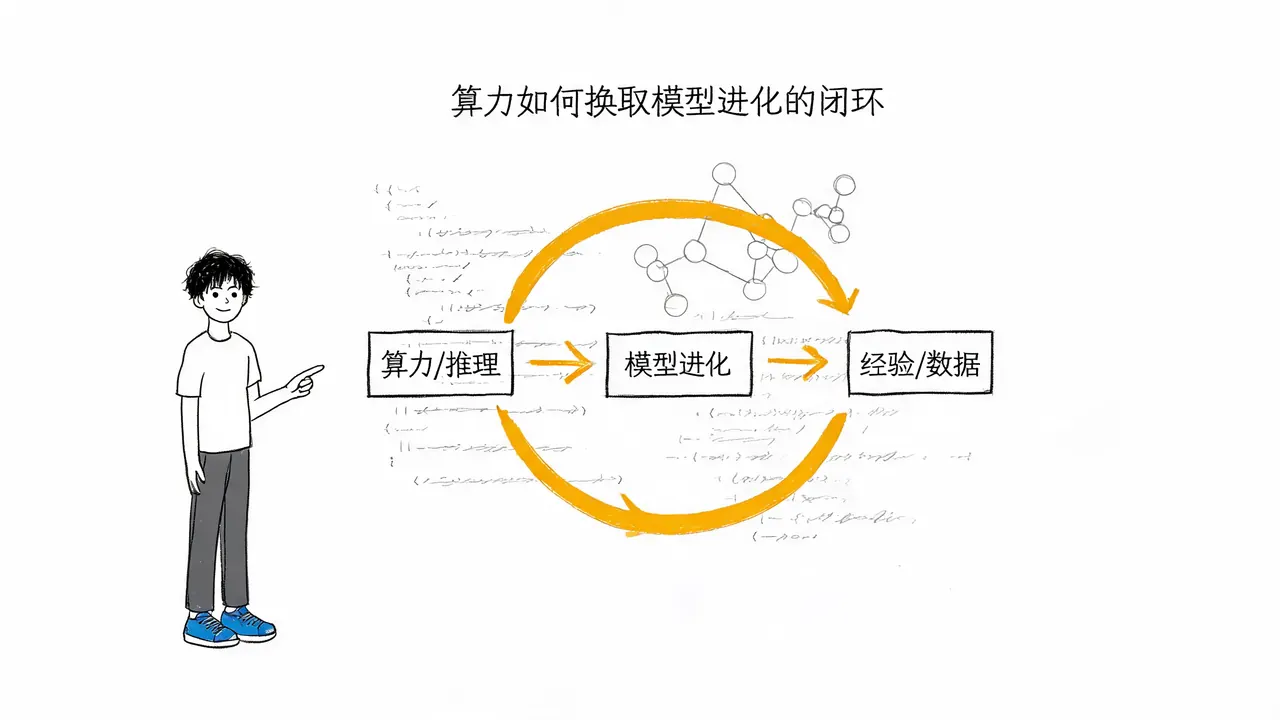
互联网文本虽多,但带结果标签的经验稀缺。合成数据需裁判机制,大规模应用产生的经验轨迹才是下一代模型的核心原料。算力从一次性训练转向持续实验,验证器边界决定自主学习上限。
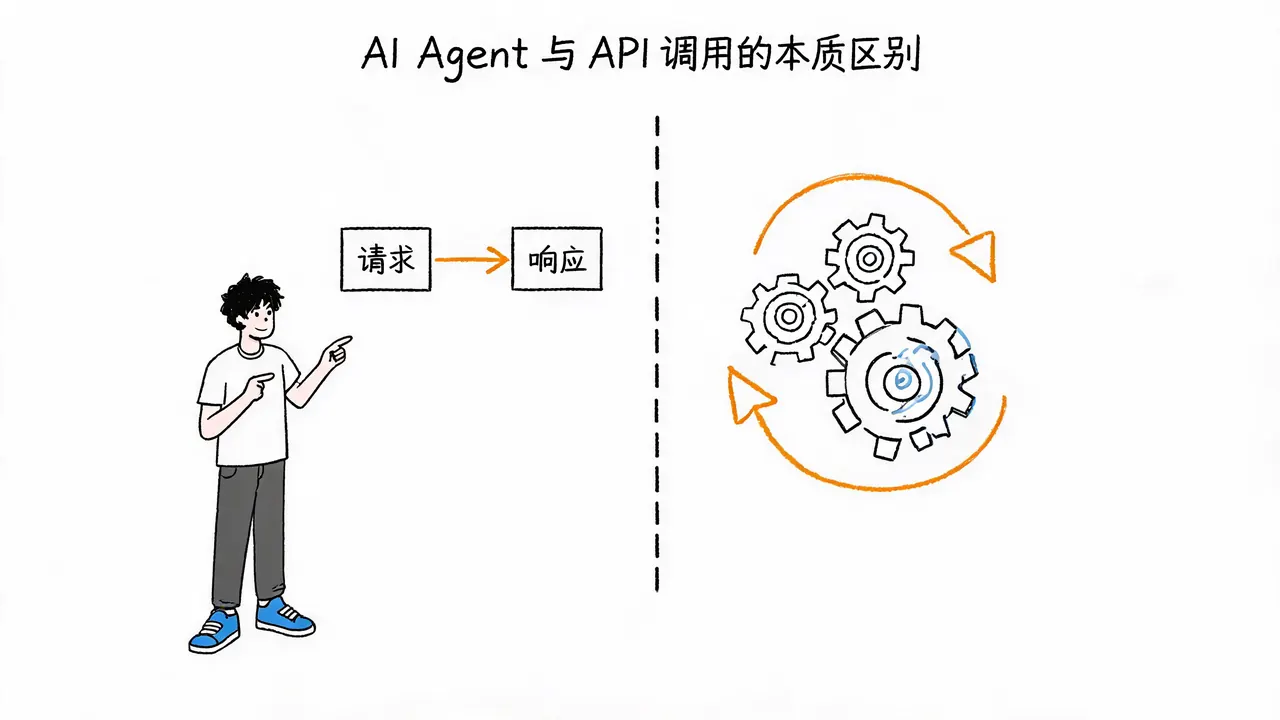
接入大模型 API 不等于拥有 AI Agent。本文深入解析 Agent 的目标驱动特性、五大核心组件及执行闭环,对比普通 API 调用的差异,并探讨成本、错误累积及安全边界等工程约束,帮助开发者正确理解并构建可靠的智能体系统。
本文深入探讨 OpenClaw 如何重新定义 AI 交互方式。通过结合聊天入口、本地运行环境与 AI 编程工具,OpenClaw 将 AI 从“思考者”转变为“执行者”,实现了真正的自动化办公。文章分析了其核心架构优势及“养龙虾”现象背后的用户心理,并指出其作为“点火器”对大众 AI 认知的启蒙作用。
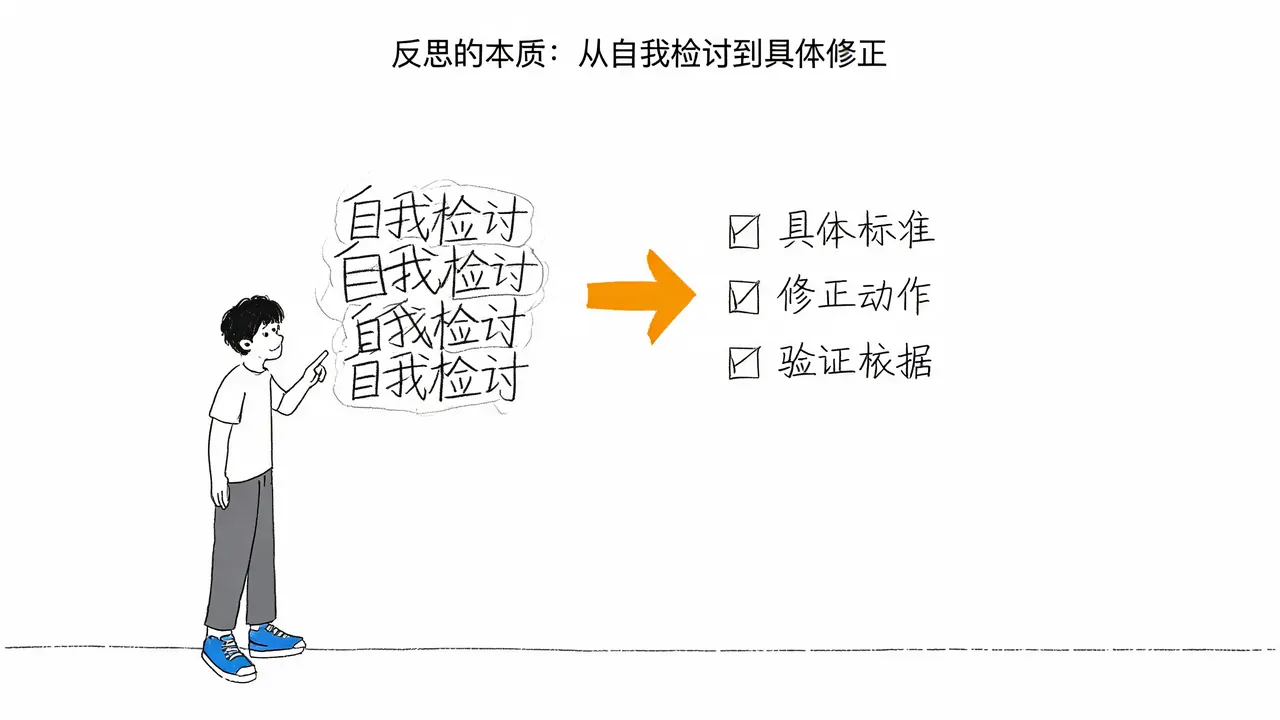
大模型常出现“诚恳道歉但答案依旧错误”的现象,这是因为缺乏外部验证的反思往往只是换种说法。本文探讨如何在系统中分离自我评价与外部验证,通过设定具体验收标准、引入客观证据及明确停止条件,构建受约束的纠错流程。
本文通过一个真实的重复支付事故案例,深入剖析接口幂等性在并发场景下的失效原因。提出业务分级、兜底校验与架构优化三层防御体系,帮助后端工程师构建高可靠的幂等保障方案,避免线上资损。
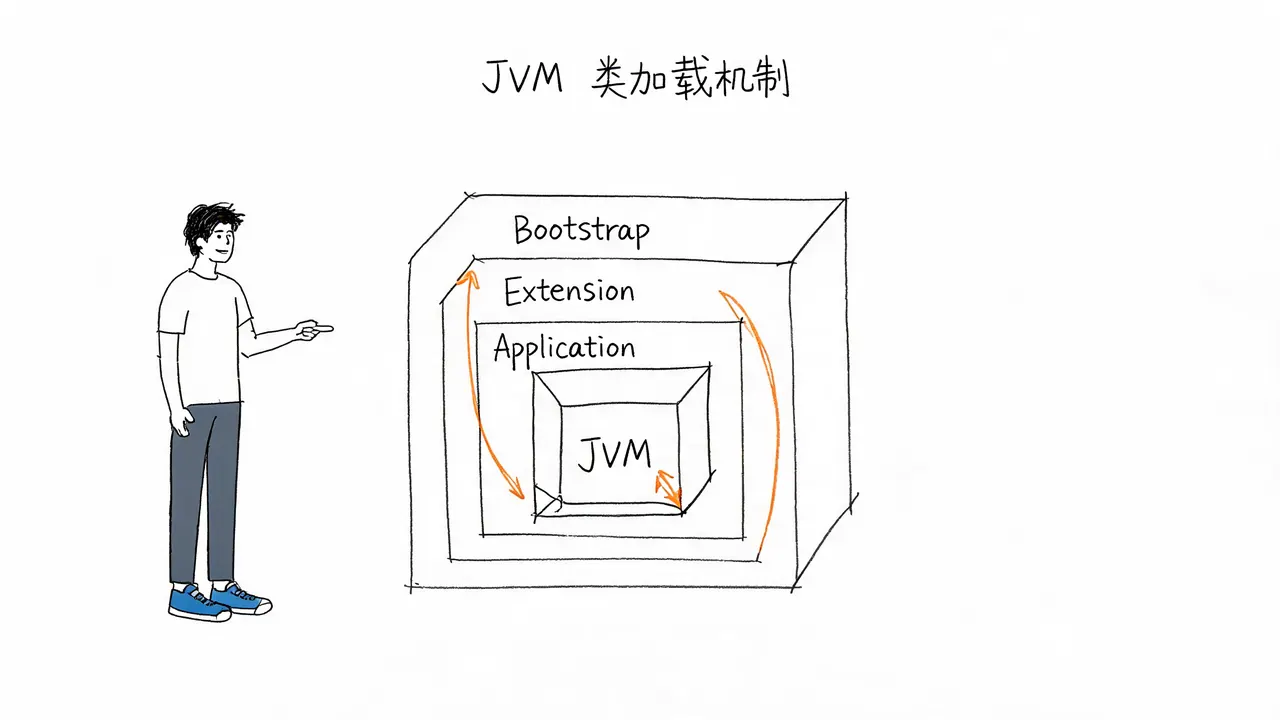
本文深入剖析 JVM 双亲委派模型的设计初衷,超越“避免重复加载”的表层认知,探讨其在安全性、全局唯一性方面的核心价值,并解析 Tomcat、OSGi 等场景下打破双亲委派的工程实践与自定义类加载器的关键要点。
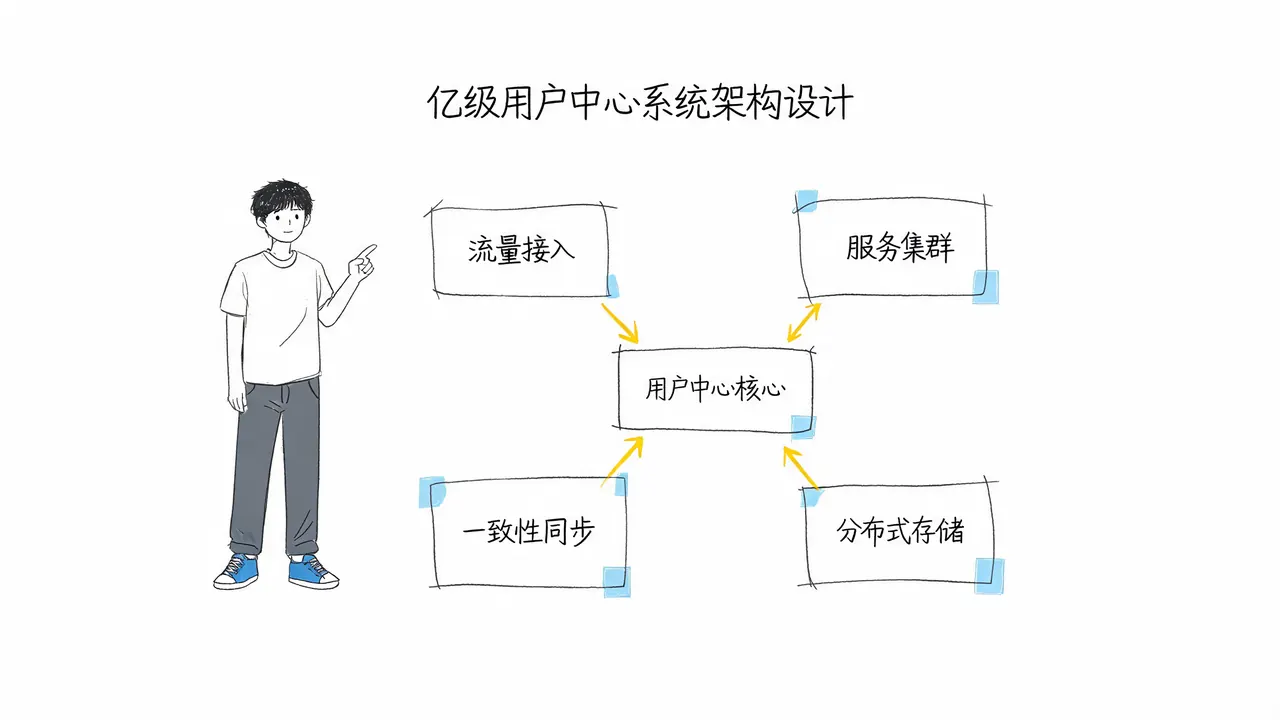
本文深入解析一道大厂后端 P7 级高频面试题:如何设计支持亿级用户体量的用户中心系统。文章从流量分层、服务拆分、存储体系、一致性保障、多集群协同及安全成本六个维度,拆解高可用、高并发分布式架构的核心得分点,帮助开发者构建完整的架构思维。
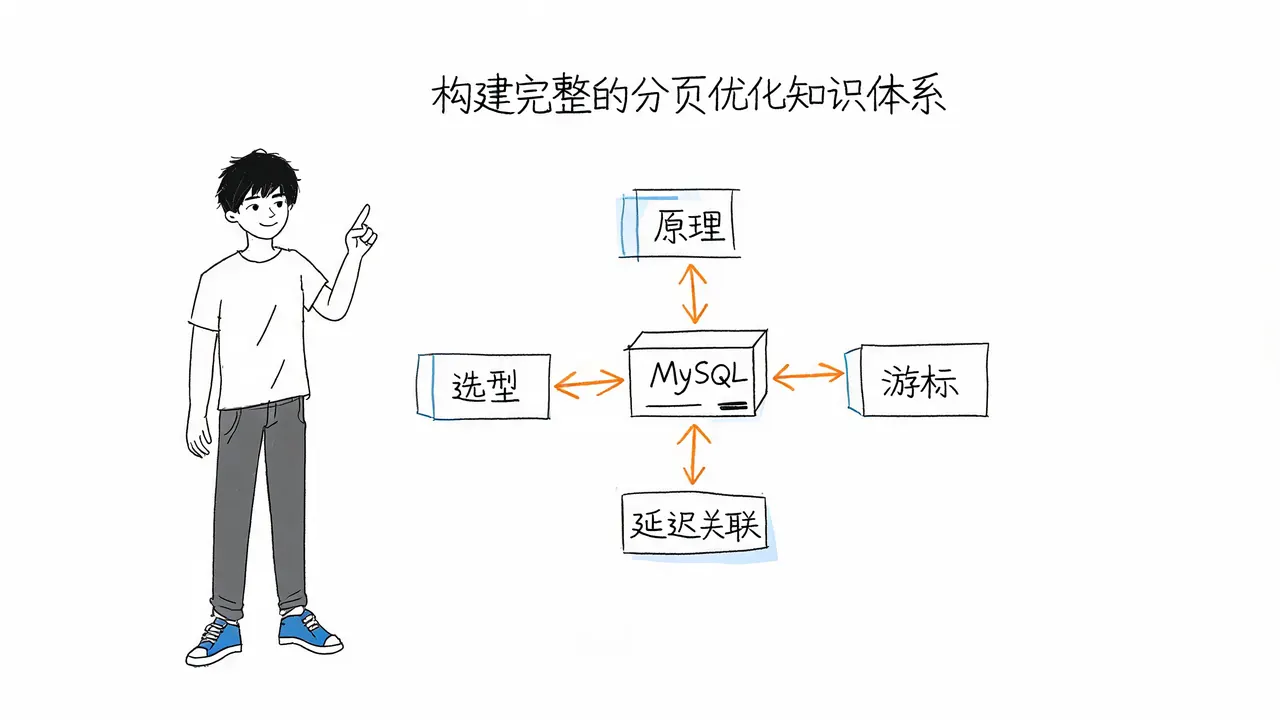
深入剖析 MySQL 深分页性能瓶颈,对比 ID 游标法与延迟关联方案的适用边界,提供从底层原理到架构选型的完整优化策略,助力后端开发者应对高级面试与生产环境挑战。
本文深入剖析 Spring @Transactional 注解的底层 AOP 代理机制,详解导致事务回滚失效的常见误区(如私有方法、内部调用、异常类型不匹配等),并提供生产环境最佳实践,帮助开发者在面试与实战中精准掌握事务控制。
本文通过一个真实的线上服务假死案例,深入剖析线程池配置背后的隐性风险。从业务分级、监控熔断到架构优化,构建三层防御体系,解决线程池集体卡死难题,提升后端高并发稳定性。